ワークフローは作った日より、動き続けている日のほうがずっと長くなります。セルフホストのn8nで困るのは、作るときではなく、止まったことに誰も気づかない日です。ここでは「問い合わせ受付」ワークフローを例に、エラーの通知、外からの見張り、実行履歴の掃除、バックアップ、アップデート、脆弱性への対応までを一通り組みます。前提は、VPSに公式のDocker Compose構成でn8nを立て、n8n.example.co.jp のような独自ドメインとHTTPSで使っている状態です。版はn8n 2.44.7(2026年10月時点のstable)で確かめています。
先に決めること
エラーの通知を業務の通知と分ける
「問い合わせ受付」は #問い合わせ に新着を流します。エラーの通知も同じチャンネルに流すと、新着に埋もれて誰も読まなくなります。実際に本番で動かしていると、エラーを業務の通知と同じ場所に流していたせいで、数日分の失敗に誰も気づかなかったことがありました。エラー専用に #n8n-監視 を作り、見る担当と、その人が休むときの代わりを決めます。
見張りはn8nの外に置く
n8nの中に作ったエラー通知は、n8nが動いているときしか働きません。n8nそのものが落ちた、証明書が切れた、VPSが止まった、という止まり方は外から見張るしかありません。外部の死活監視サービスを1つ使うと決めます。
版は番号で固定する
イメージのタグを stable のままにすると、再起動のついでに知らない版へ上がることがあります。番号で固定し、月に1回、自分のタイミングで上げます。
バックアップと暗号鍵の置き場所
バックアップをVPSの中にだけ置くと、VPSごと失ったときに一緒に消えます。送り先はVPSの外(別のサーバー、オブジェクトストレージ、社内のNASなど)にします。Credential(認証情報)を暗号化している鍵 N8N_ENCRYPTION_KEY は、社内のパスワード管理ツールに別にしまいます。
運用でやることの一覧
| やること | 頻度 | 使うもの |
|---|---|---|
| エラー用ワークフロー | 常時 | Error Trigger、Slack |
| 外からの死活監視 | 常時 | /healthz/readiness、外部の死活監視サービス |
| 毎朝の生存確認 | 毎日 | Schedule Trigger |
| 実行履歴の削除 | 常時(自動) | EXECUTIONS_DATA_PRUNE ほか |
| バックアップ | 毎日 | CLIのエクスポートと、データフォルダの丸ごと保存 |
| 戻せるかの試し | 毎月 | 手元のPCのDocker |
| アップデート | 毎月 | release notes、docker compose pull |
| 脆弱性の確認 | 毎週 | GitHub Security Advisories |
| セキュリティ監査 | 毎月 | n8n audit |
手順
1. エラー用ワークフローを作る
ワークフローが失敗したら #n8n-監視 に知らせるワークフローを1本作ります。1本を複数のワークフローで共有できます。
- 新しいワークフローを作り、名前を「エラー通知」にします。
- 最初のノードに「Error Trigger」(ほかのワークフローが失敗したときに動くトリガー)を置きます。
- 「Slack」ノードを足し、Resourceを「Message」、Operationを「Send」にします。
- 「Send Message To」を「Channel」にし、「Channel」に #n8n-監視 を指定します。「Message Text」に下の式を入れて保存します。
n8nでエラーが起きました
ワークフロー: {{ $json.workflow.name }}
止まったノード: {{ $json.execution?.lastNodeExecuted || 'トリガー' }}
内容: {{ $json.execution?.error?.message ?? $json.trigger.error.message }}
実行の画面: {{ $json.execution?.url || '(保存されていません)' }}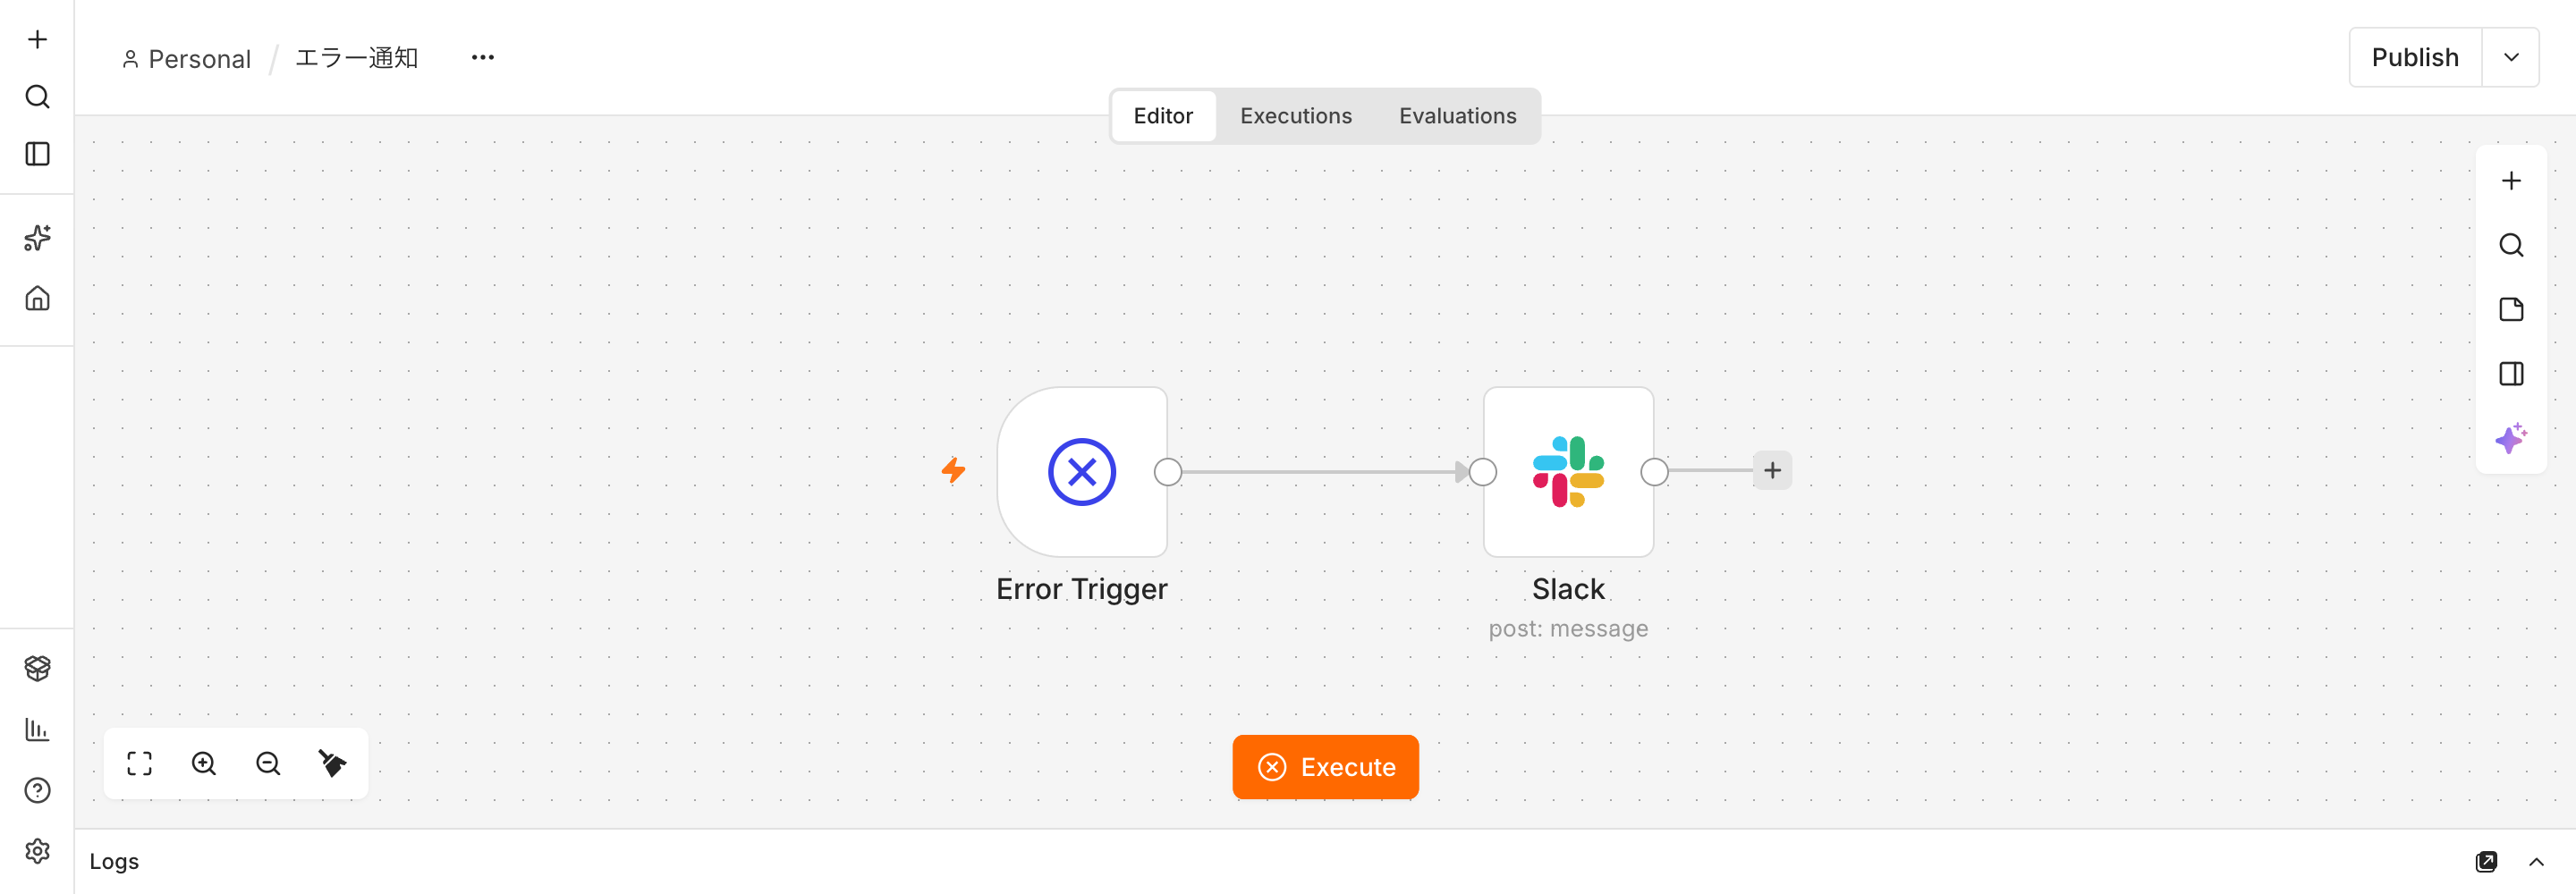
トリガーそのもので失敗したときは execution 自体が無く、代わりに trigger.error に内容が入ります。式で両方を見て ?. を付けているのはこのためで、$json.execution.lastNodeExecuted のように書くと、トリガーで失敗したときだけその欄が空の通知が届きます。Error Triggerを使うワークフローは公開(Publish)しなくても動きます。
次に、見張る側のワークフローで指定します。
- 「問い合わせ受付」を開き、ワークフロー名の右にある「…」メニューから「Settings」を開きます。
- 「Error Workflow」で「エラー通知」を選び、保存します。
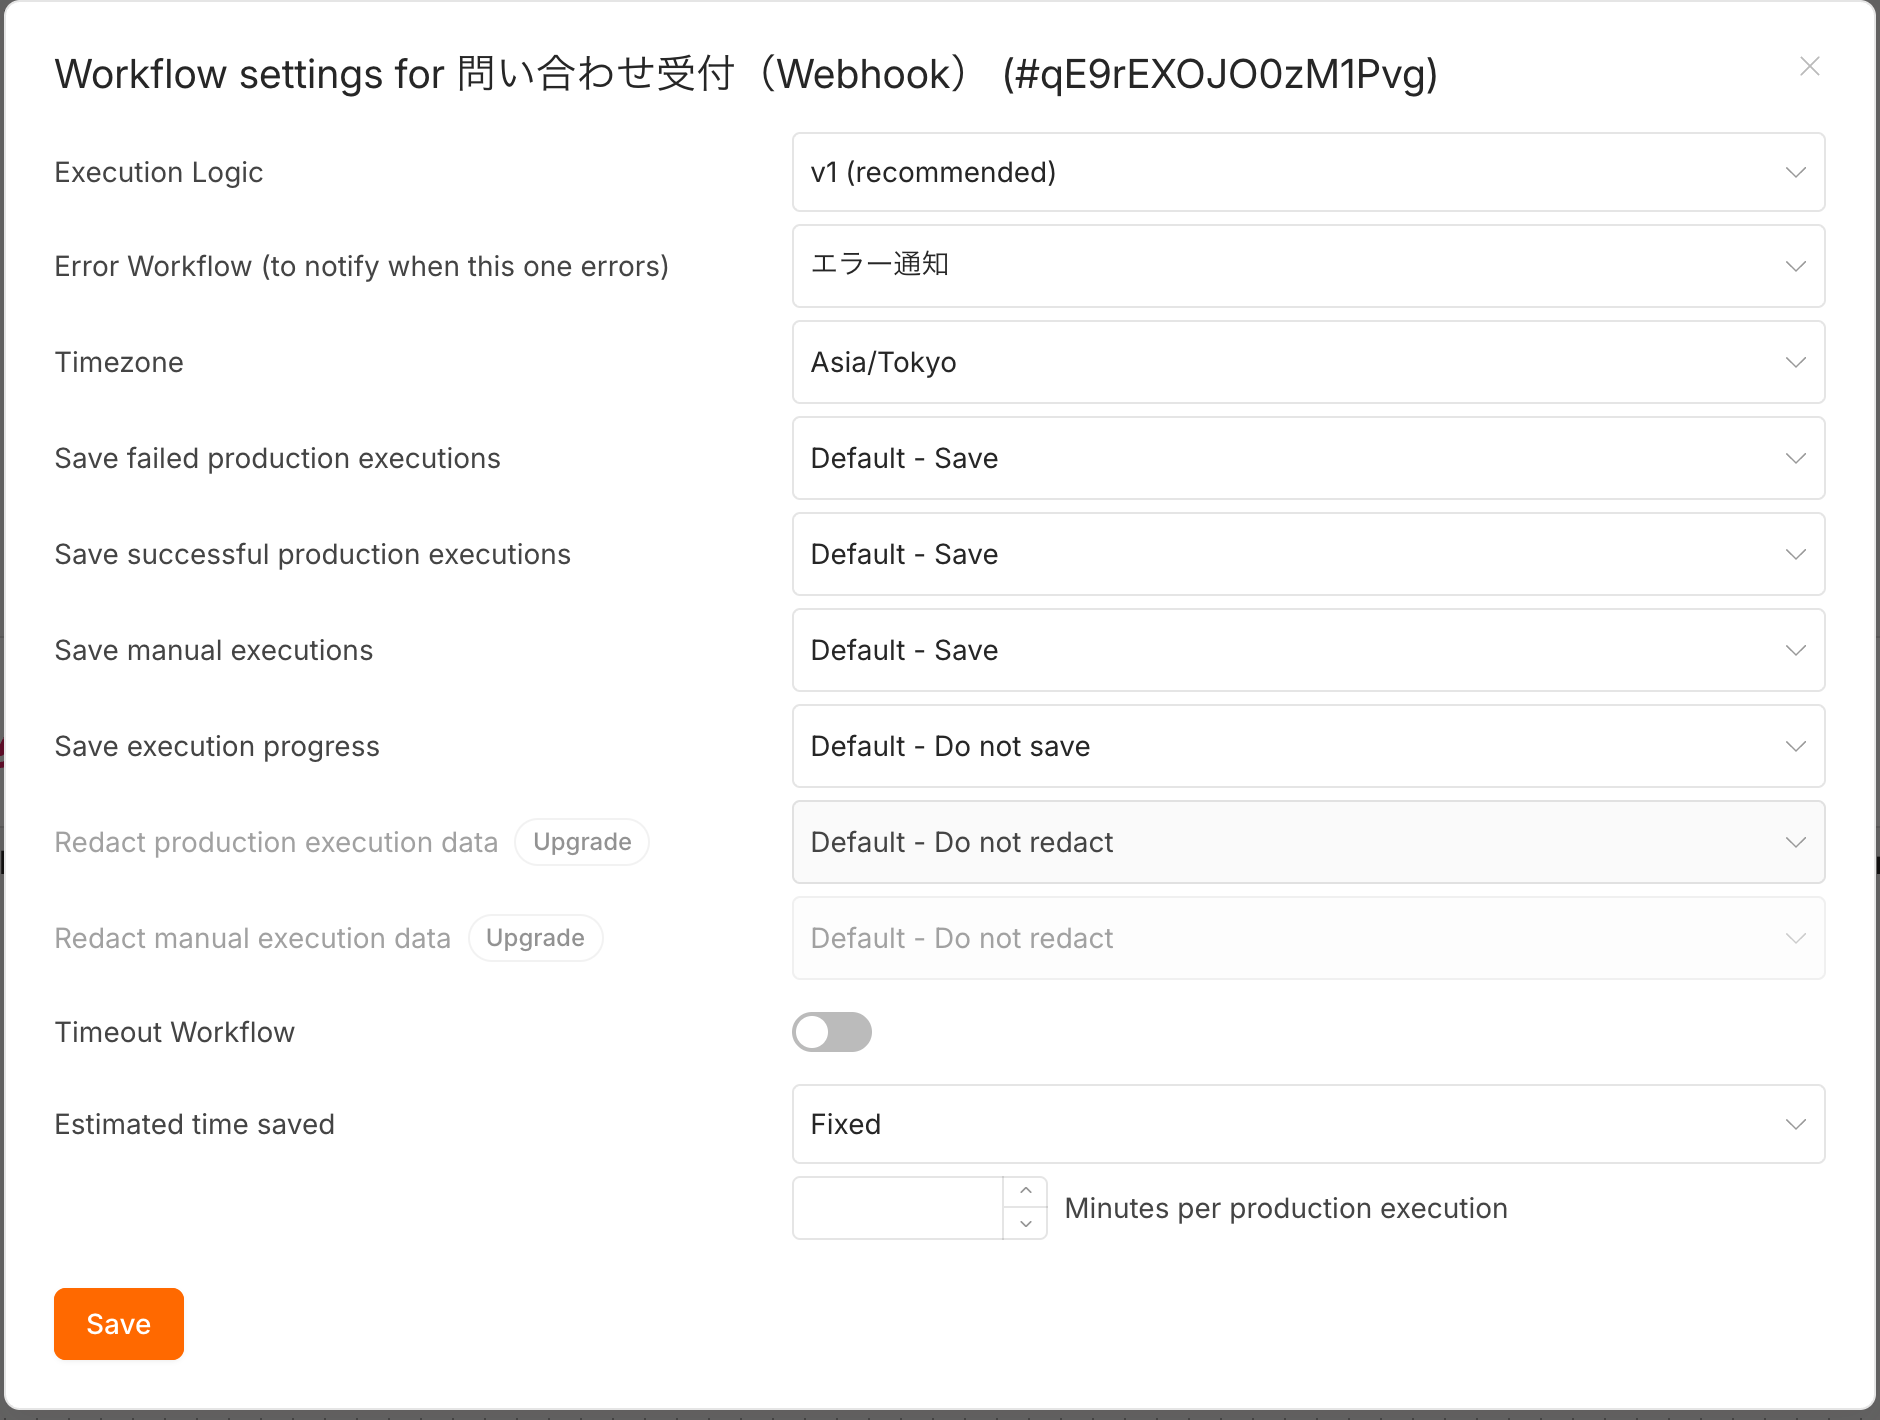
最後に試します。Error Triggerは手動実行の失敗では動きません。「Execute workflow」(ワークフローを実行)を押して試しても通知は来ないので、試験用のワークフローを作ります。
- 「Schedule Trigger」(決まった時刻に動くトリガー)を置き、Trigger Intervalを「Minutes」、間隔を1分にします。
- 「Stop and Error」(わざとエラーで止めるノード)をつなぎます。
- Settingsの「Error Workflow」で「エラー通知」を選び、保存して公開します。
- #n8n-監視 に通知が来たら公開を取り消します。
2. 失敗の扱いをノードごとに決める
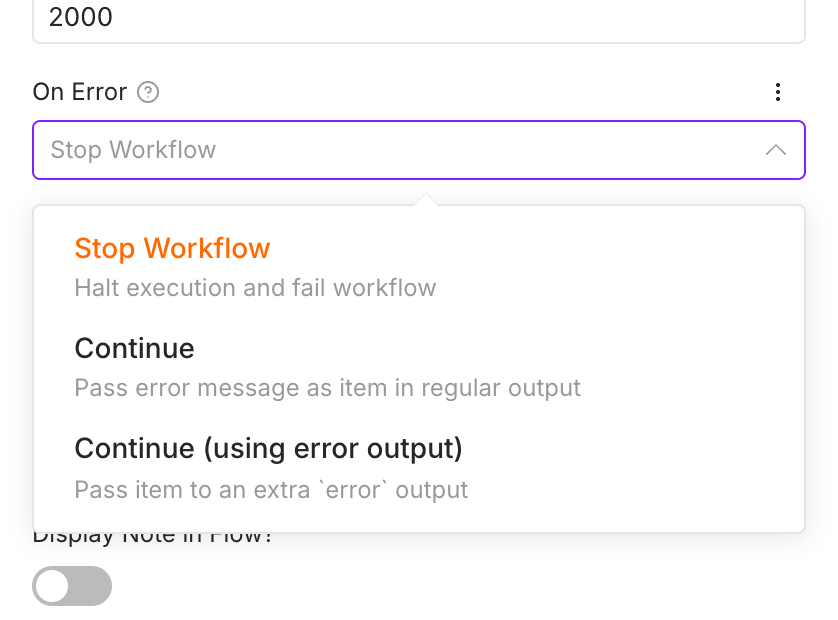
エラー用ワークフローが拾うのは、ワークフローが失敗で終わったときだけです。ノードの「Settings」タブの「On Error」を変えると、通知の届き方も変わります。
| 設定 | 動き | 通知 |
|---|---|---|
| Stop Workflow | その場で止める(既定) | 届く |
| Continue | 直前の正しいデータで次へ進む | 届かない |
| Continue (using error output) | エラーの内容を別の出口に流す | 出口の先で止めれば届く |
「Continue」は失敗が黙って消えます。運用しているn8nで、顧客を探すノードを「Continue」にしていたため、検索そのものが失敗したときも「該当なし」として流れ、実在する顧客からの連絡を取りこぼしたことがありました。続行させるなら「Continue (using error output)」にし、エラーの出口の先に「Stop and Error」を置きます。
3. n8nの外から見張る
| 止まり方 | 実行一覧に残るか | 見張り方 |
|---|---|---|
| コンテナやVPSが止まった | 残らない | 外部から /healthz/readiness を見る |
| 証明書の期限が切れた | 残らない | 外部から証明書の残り日数を見る |
| 定期実行が黙って止まった | 残らない | 毎朝の生存確認 |
| メール受信のトリガーが再接続に失敗した | 残らない | 毎朝の生存確認とトリガーの設定 |
n8nには死活確認の入口が2つあります。/healthz はn8nに届けば200を返しますが、データベースの状態は見ていません。/healthz/readiness はデータベースにつながり、移行も済んでいるときだけ200を返します。外部の死活監視サービスには https://n8n.example.co.jp/healthz/readiness を登録し、数分おきに見てもらいます。証明書の残り日数も見られるなら、30日を切ったら知らせる設定にします。
証明書は特に危ないところです。運用しているn8nで証明書の自動更新が止まり、期限が切れたことがありました。フォームからWebhookへの送信がHTTPSのエラーで弾かれるので、n8nには何も届きません。実行もエラーも残らず、通知が全部止まったことに気づいたのは問い合わせの件数が減ってからでした。
4. 毎朝の生存確認を作る
- 新しいワークフロー「毎朝の生存確認」に「Schedule Trigger」を置き、Trigger Intervalを「Days」、Trigger at Hourを8にします。
- 「HTTP Request」ノードで、外部の死活監視サービスが発行するハートビート用のURLへGETを送ります。
- 「Slack」ノードで #n8n-監視 に「n8nは動いています」と送ります。
- 保存して公開します。
人は来なかった通知に気づけません。ハートビート監視は「決まった時間までに連絡が無ければ知らせる」仕組みなので、こちらを本命にします。
メール受信のトリガーには別の注意があります。運用しているn8nで、「Email Trigger (IMAP)」(メール受信で動くトリガー)がメールサーバー側の長時間の切断のあと再接続に失敗し、ワークフローごと止まったことがありました。起動時の失敗なので実行一覧には何も残りません。このトリガーには「Force Reconnect Every Minutes」(決まった分数ごとに接続し直す)があるので、数十分おきの値を入れます。短くしすぎると接続の回数が増え、失敗の機会も増えます。Gmailなら、Gmailのノードで受け取る形に替えると問題そのものが消えます。
2.45.0からは定期実行の仕組みが「durable scheduler」に変わり、既定でオンになります。n8nが止まっていた間に予定時刻を過ぎた回は、1分(既定の猶予)以内なら遅れて実行され、それを過ぎた回は既定では捨てられて、次の予定から再開します。生存確認が来なかった朝は、ほかの定期実行も止まっていたと考えて実行一覧を確かめます。
5. 実行履歴の保存と削除を決める
n8nは既定でSQLiteを使い、ワークフロー、Credential、実行履歴を ~/.n8n/database.sqlite(Dockerならコンテナの /home/node/.n8n)に入れています。
| 環境変数 | 既定値 | 意味 |
|---|---|---|
EXECUTIONS_DATA_PRUNE | true | 古い実行履歴を自動で消す |
EXECUTIONS_DATA_MAX_AGE | 336 | この時間より古い履歴を消す(336時間=14日) |
EXECUTIONS_DATA_PRUNE_MAX_COUNT | 10000 | 残す件数の上限。0 で無制限 |
EXECUTIONS_DATA_SAVE_ON_ERROR | all | 失敗した実行を保存する |
EXECUTIONS_DATA_SAVE_ON_SUCCESS | all | 成功した実行を保存する |
DB_SQLITE_VACUUM_ON_STARTUP | false | 起動時にデータベースを詰め直す |
「問い合わせ受付」程度なら既定のままで困りません。1分おきに動くワークフローが増えてきたら、成功した実行を残さない設定にします。失敗した実行は残します。残さないと、エラー通知に実行の画面のリンクが出ません。.env に次を足します。
EXECUTIONS_DATA_MAX_AGE=168
EXECUTIONS_DATA_SAVE_ON_SUCCESS=none
EXECUTIONS_DATA_SAVE_ON_ERROR=all
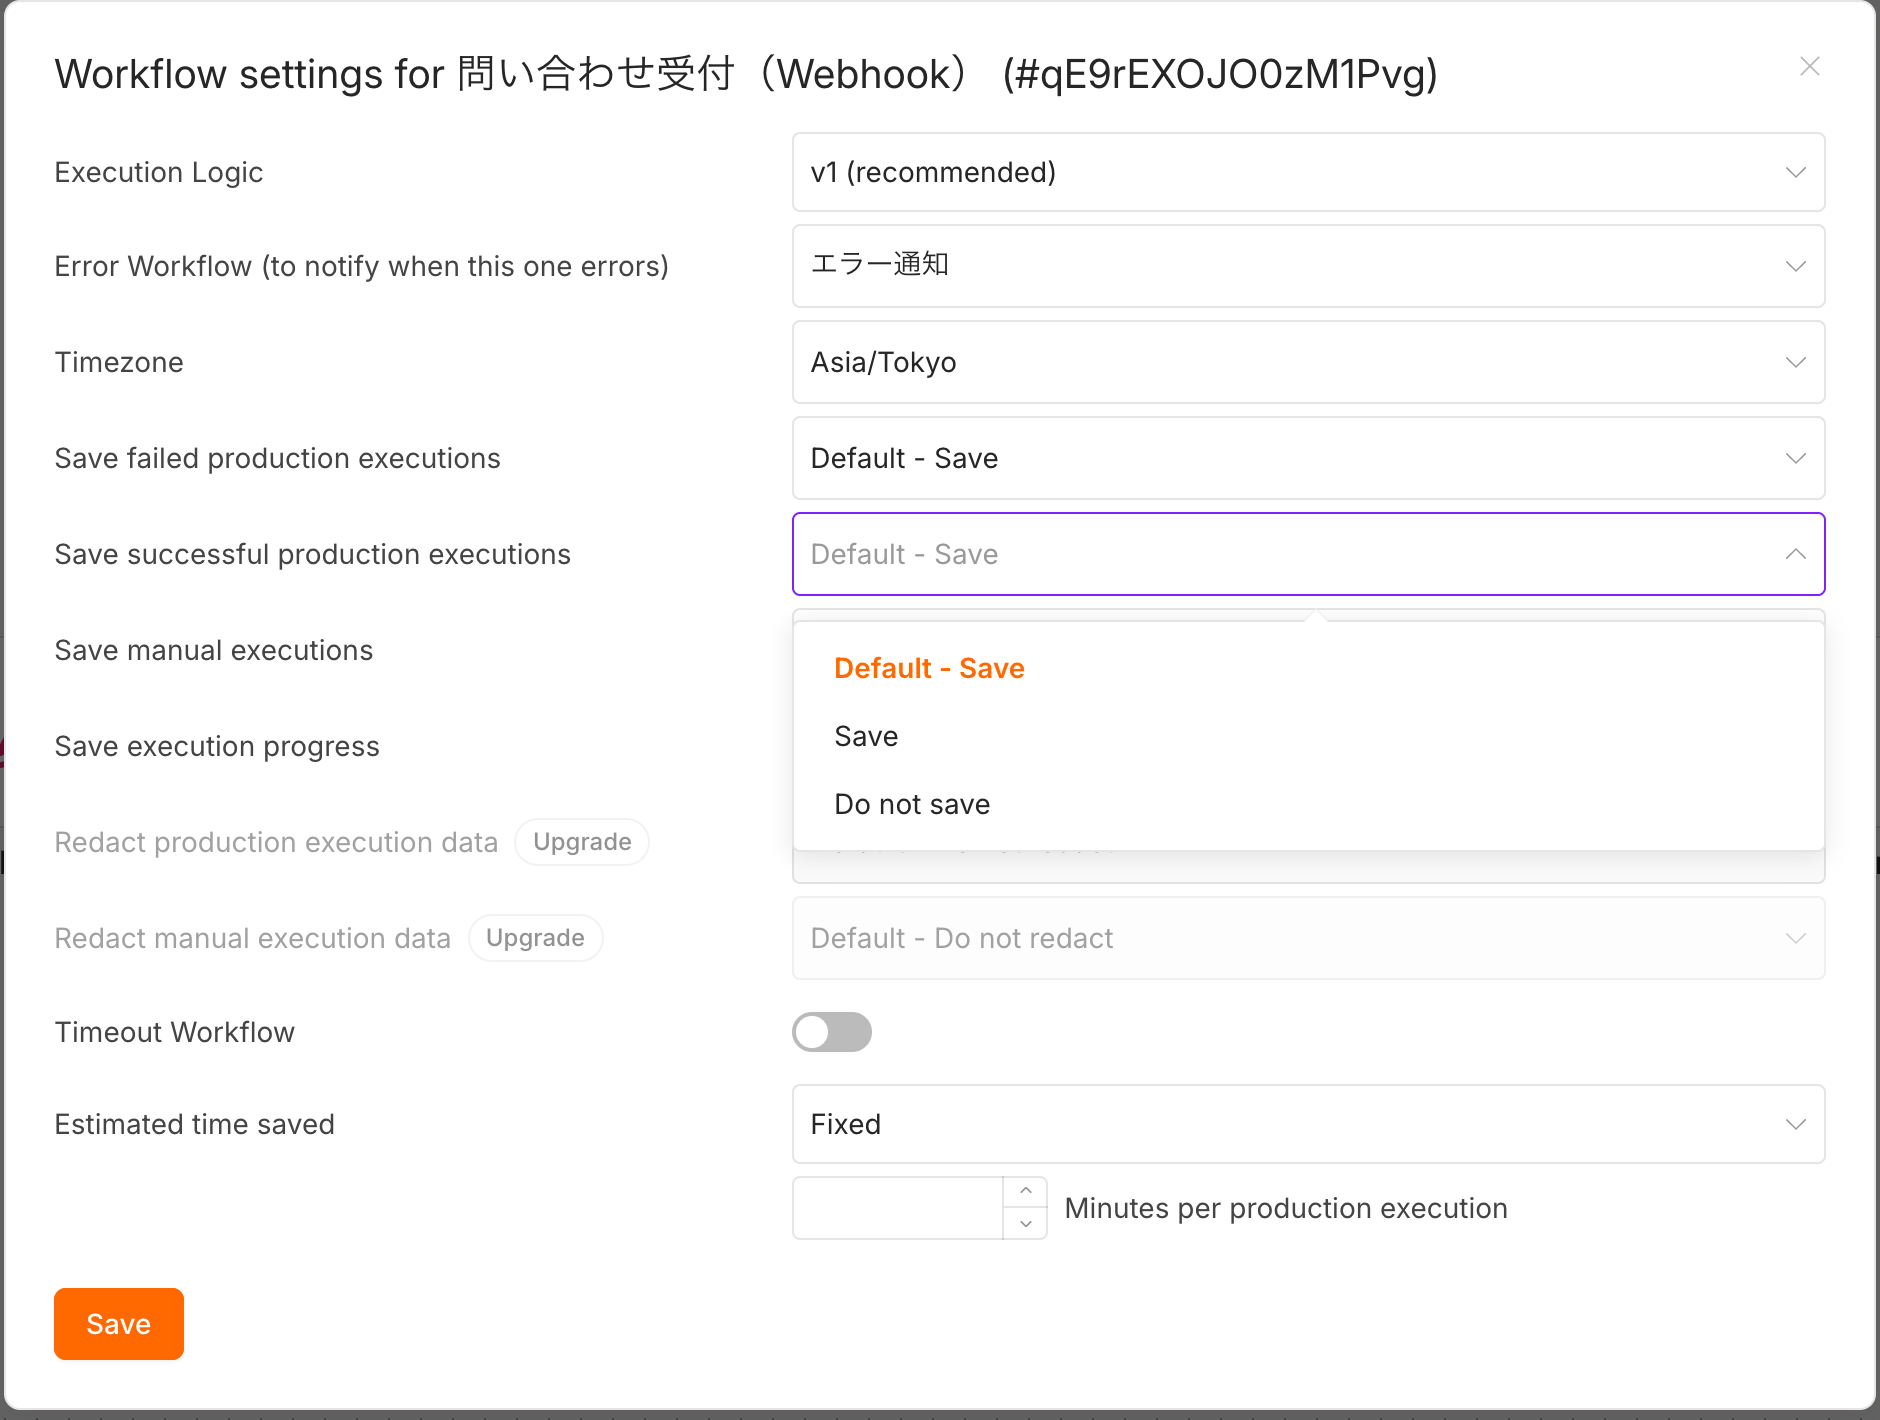
ワークフローごとに決めたいときは、Settingsの「Save successful production executions」で変えられます。
SQLiteは、履歴を消してもファイルが小さくなりません。空いた場所が使い回されるだけです。小さくしたいときは DB_SQLITE_VACUUM_ON_STARTUP=true で一度だけ再起動し、終わったら false に戻します。起動に時間がかかり、その間は何も動かないので夜間に行います。運用しているn8nでデータベースが1GBを超えたとき、コピーだけで10分以上かかるようになりました。
6. バックアップを取る
| 方法 | 入るもの | 入らないもの |
|---|---|---|
| CLIのエクスポート | ワークフロー、Credential | ユーザーと権限、実行履歴、Variables、暗号鍵を含む設定 |
| データフォルダの丸ごと保存 | 上のすべて(SQLiteの場合) | 外に置いたPostgreSQLなど |
丸ごと戻せるのはデータフォルダのほうです。両方を毎日取ります。
丸ごと保存はn8nを止めてから取ります。動いている最中にデータベースをコピーすると、中身の食い違ったバックアップになることがあります。2.xのSQLiteは既定でWALモードで動き(2.44.7で確かめています)、database.sqlite の横に -wal と -shm のファイルができます。直近の書き込みはWALの側にあることがあり、運用しているn8nで database.sqlite だけをコピーしたら直前の変更が入っていなかったことがありました。フォルダごと保存すれば全部入ります。
下は毎日3時に動かすスクリプトです。止まるのは数十秒から数分なので、問い合わせの少ない時間帯を選びます。ボリューム名は docker volume ls で確かめます(公式構成なら n8n_n8n-data)。ワークフローとCredentialは別のフォルダに書き出します。同じフォルダに混ぜると、Credentialの読み込みが失敗します。
#!/bin/sh
set -eu
cd ~/n8n
DAY=$(date +%F)
mkdir -p backups
docker compose exec -T -u node n8n n8n export:workflow --backup --output=/home/node/.n8n/backups/workflows/
docker compose exec -T -u node n8n n8n export:credentials --backup --output=/home/node/.n8n/backups/credentials/
docker compose stop n8n
docker run --rm -v n8n_n8n-data:/data:ro -v "$PWD/backups":/backup alpine \
  tar czf "/backup/n8n-data-$DAY.tgz" -C /data .
docker compose start n8n
scp "backups/n8n-data-$DAY.tgz" backup@backup.example.co.jp:/srv/n8n-backups/
find backups -name 'n8n-data-*.tgz' -mtime +14 -delete
~/n8n/backup.sh に保存して実行権を付け、crontab -e に 0 3 * * * /home/ubuntu/n8n/backup.sh >> /home/ubuntu/n8n/backup.log 2>&1 を足します。--backup は全件を1本ずつ別のJSONに書き出す指定です。Credentialは暗号化されたまま出ます。--decrypted を付けると平文で出るので、普段は使いません。
暗号鍵は別に保管します。n8nは初回起動時に鍵を作り、~/.n8n の設定ファイル(config)に保存します。鍵が違うn8nにデータを戻すと、Credentialは1つも開けません。.env に N8N_ENCRYPTION_KEY をまだ書いていないなら、docker compose exec -u node n8n cat /home/node/.n8n/config で今の鍵を写して .env に書き、同じ値をパスワード管理ツールにしまいます。新しい鍵を作るのではなく、今の鍵を写すところが大事です。
7. 戻せるかを試す
バックアップは、戻せると確かめるまでは無いのと同じです。月に1回、手元のPCで試します。
- 手元のPCに本番と同じ構成を用意し、
.envのN8N_VERSIONとN8N_ENCRYPTION_KEYを本番と同じにします。 - 起動する前に、空のボリュームへバックアップを展開します。
- 起動したらすぐ、公開中のワークフローを全部取り消します。残すと定期実行が手元でも動き、Slackへ二重に投稿されます。
- 本番と同じアカウントでログインできるか確かめます。
- 「問い合わせ受付」を開き、GoogleスプレッドシートのCredentialで接続の確認が通るか確かめます。
- 終わったら手元の環境を消します。
docker volume create n8n_n8n-data
docker run --rm -v n8n_n8n-data:/data -v "$PWD":/backup alpine \
  tar xzf /backup/n8n-data-2026-10-26.tgz -C /data
docker compose up -d
docker compose exec -u node n8n n8n unpublish:workflow --all
8. アップデートする
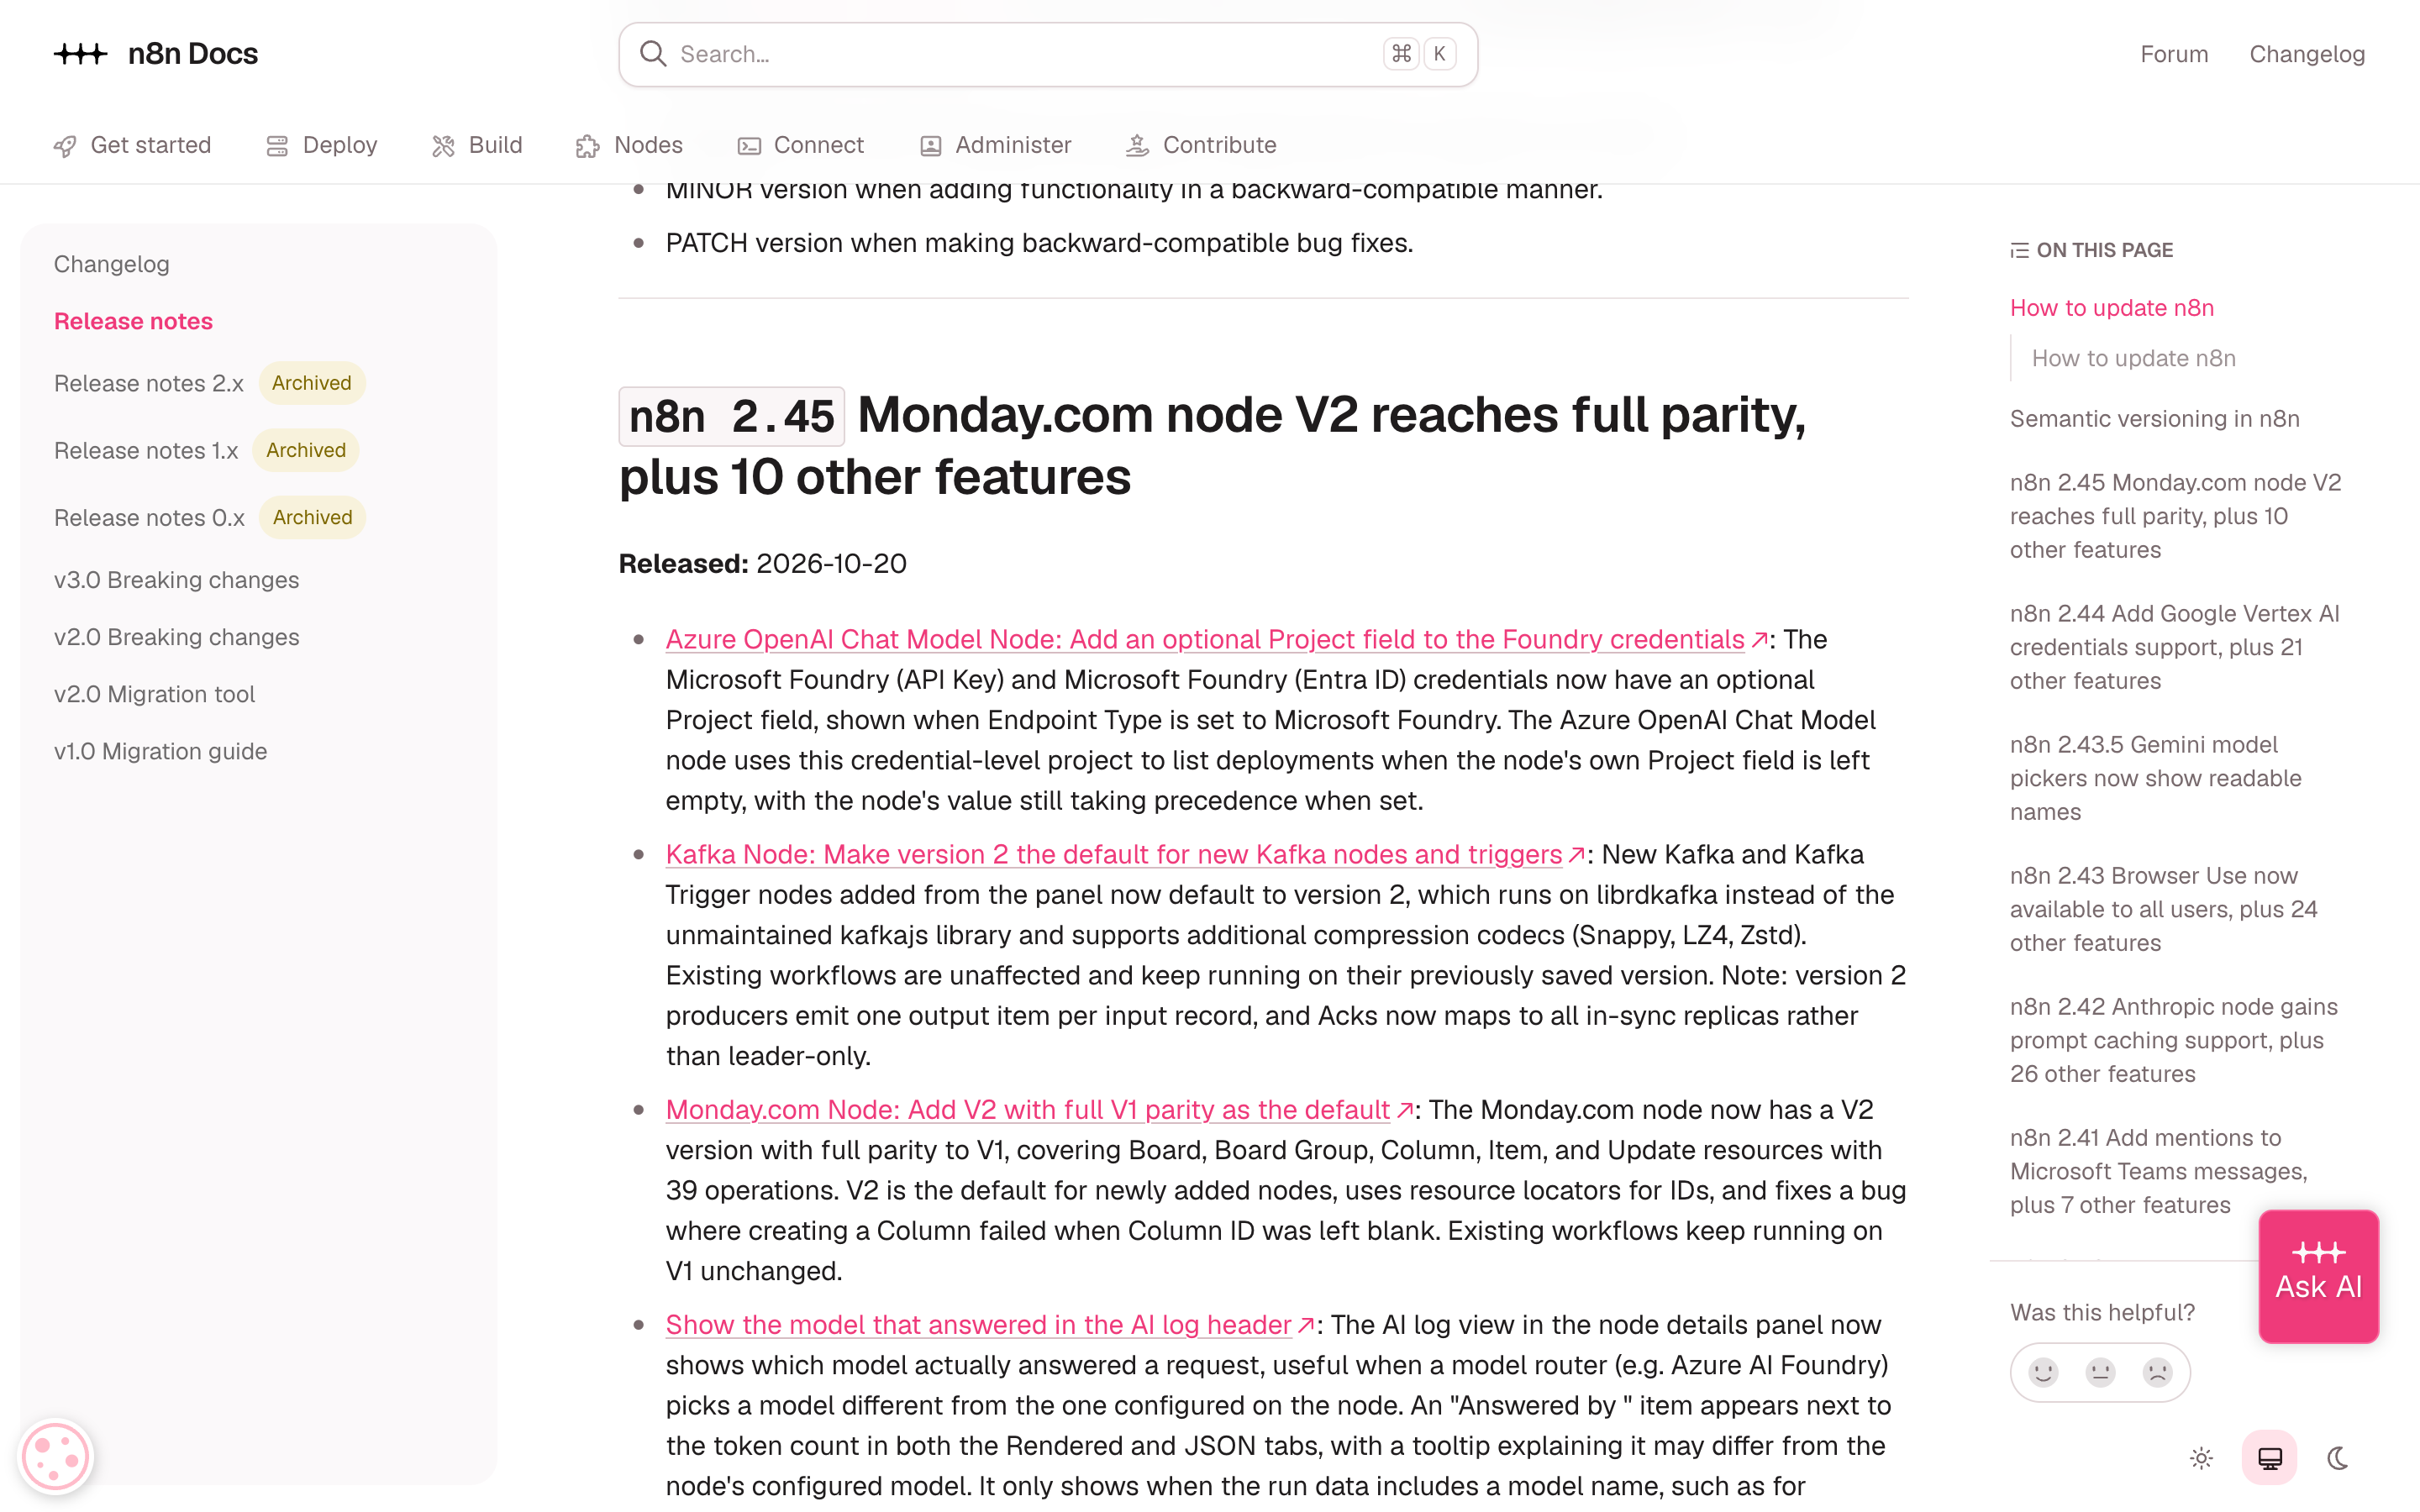
公式は少なくとも月に1回の更新を勧めています。何版もまとめて飛ばすと、壊れたときに原因を追えなくなります。タグは stable が本番向け、beta がいちばん新しく不安定なこともある版です。2.0からタグ名が latest は stable に、next は beta に変わり、公式も番号での固定を勧めています。公式のDocker Compose構成では、.env の N8N_VERSION がn8n本体とrunnersの版を決めます。サンドボックス用の3つのイメージは別の N8N_SANDBOX_VERSION で固定されているので、本体とは別に扱います。
- release notesで、今の版から上げる版までの breaking changes(互換性のない変更)を読みます。
- 手順6のスクリプトを手で動かし、更新前のバックアップを取ります。
.envのN8N_VERSIONを上げる版の番号に書き換えます。docker compose pullで新しいイメージを取ってきます。docker compose downで今のコンテナを止めます。docker compose up -dで起動します。docker compose logs -f n8nで、データベースの移行が終わりエラーが無いことを見ます。/healthz/readinessが200を返すか確かめます。- フォームから試しに1件送り、シートとSlackまで届くか確かめます。
公式の更新手順には戻し方が無く、バックアップと復元のページに、データフォルダを丸ごと戻す復元の手順があります。新しい版は起動時にデータベースを移行することがあるので、番号だけを戻すと古い版が新しい形のデータベースを読むことになります。戻すときは、番号を戻したうえで手順2のデータフォルダを丸ごと戻します。更新後に受けた問い合わせの実行履歴は消えるので、戻す前にシートで確かめておきます。
1.xから上げる場合は、2.0の変更点を先に読みます。運用に効くのは次のあたりです。
| 2.0での変更 | 対処 |
|---|---|
| 「Activate」が「Publish」になり、編集しただけでは本番に出ない | 編集後に公開し直す |
| Codeノードから環境変数が読めない | 値をCredentialや「Edit Fields」に移す |
| 「Execute Command」が既定で無効 | 使うなら NODES_EXCLUDE を見直す |
.env の読み方が変わった | バッククォートを含む値は引用符で囲む。行頭が # の行はコメント扱い |
公式は検証用のn8nで先に試すことも勧めていますが、そのためのEnvironments機能はBusinessとEnterpriseのプランのものです。無料のセルフホストなら、手順7で戻した手元のn8nに先に新しい版を当てて動きを見ます。
9. 脆弱性に備える
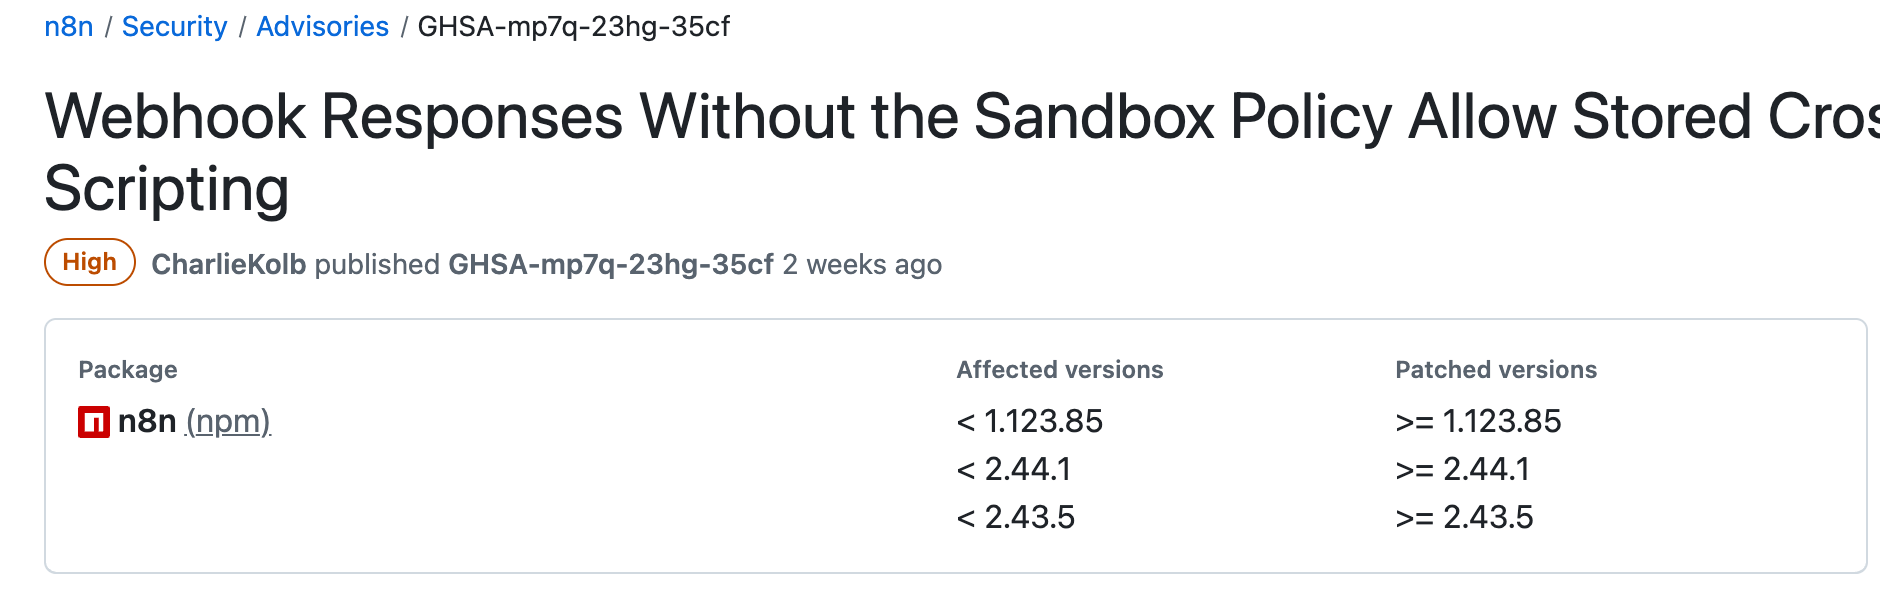
n8nの脆弱性は、GitHubの n8n-io/n8n の Security Advisories に載ります。一覧に件名、重大度(Critical、High、Moderate、Low)、公開日が並び、1件を開くと「Affected versions」(影響を受ける版)、「Patched versions」(直った版)、回避策が書かれています。
たとえば2026年10月14日には10件がまとめて公開されました。そのうち「Webhook Responses Without the Sandbox Policy Allow Stored Cross-Site Scripting」は重大度High(CVSS 8.4)で、2.44.1と2.43.5で直っています。2.44.7なら当たりません。こうして今の版が直った版より新しいかを1件ずつ見ます。
HighかCriticalが今の版に当たっていたら、その日のうちに直った版へ上げます。すぐ上げられないときは、advisoryの回避策を当てます。回避策は応急処置で、更新の代わりにはなりません。上げたあとは、見覚えのない実行やユーザー、Credentialが増えていないかを確かめます。GitHubでリポジトリの「Watch」を「Custom」にしてReleasesを選ぶと、新しい版が出たときに通知が来ます。
10. 公開する範囲を絞る
外から触れる場所が少ないほど、脆弱性の被害は小さくなります。advisoryの回避策にも、使う人を信頼できる人に限ること、/webhook/ への接続を信頼できる送り元に限ることが出てきます。
「問い合わせ受付」で外に開ける必要があるのは、フォームから呼ばれる /webhook/ と、外部監視が見る /healthz だけです。編集画面は会社のIPからだけ開けるようにします。n8nの前にnginxを置いた場合の例です。
server {
    listen 443 ssl;
    server_name n8n.example.co.jp;

    location /webhook/ {
        proxy_pass http://127.0.0.1:5678;
    }
    location /healthz {
        proxy_pass http://127.0.0.1:5678;
    }
    location / {
        allow 203.0.113.10;
        deny all;
        proxy_pass http://127.0.0.1:5678;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
    }
}
証明書の設定は導入時のものを使います。あわせてDocker Composeの ports を '127.0.0.1:5678:5678' に変えます。公式の構成は5678番を外に開けているので、そのままだとnginxを通らず直接入れてしまいます。Waitノードで外からの再開を待つワークフローがあるなら /webhook-waiting/ も開けます。在宅の人が多くIPで絞れない会社は、編集画面の側にnginxのBasic認証をかけるか、VPNを通します。
| 対策 | やり方 |
|---|---|
| 使わないなら公開APIを止める | N8N_PUBLIC_API_DISABLED=true、N8N_PUBLIC_API_SWAGGERUI_DISABLED=true |
| 2段階認証 | 各自が「Settings」→「Personal」→「Enable 2FA」。回復用コードを保管する |
| 2段階認証の強制 | 「Settings」→「Security & policies」の「Enforce two-factor authentication」(セルフホストはBusiness以上) |
| アカウントを共有しない | 使う人ごとにユーザーを作り、辞めた人はその日に消す |
| 2.0で厳しくなった既定値を戻さない | Codeノードの環境変数の遮断、Execute Commandの無効を残す |
最後にセキュリティ監査を流します。docker compose exec -u node n8n n8n audit を実行すると、使われていないCredential、SQLを式で組み立てているノード、ホストのファイルやコードに触れるノード、守られていないWebhook、古い版のままかどうかを返します。
11. 毎週・毎月の点検表を回す
| 頻度 | 見るもの | おかしいときにやること |
|---|---|---|
| 毎日 | 朝の「動いています」が来ているか | 外部監視とVPSを確かめる |
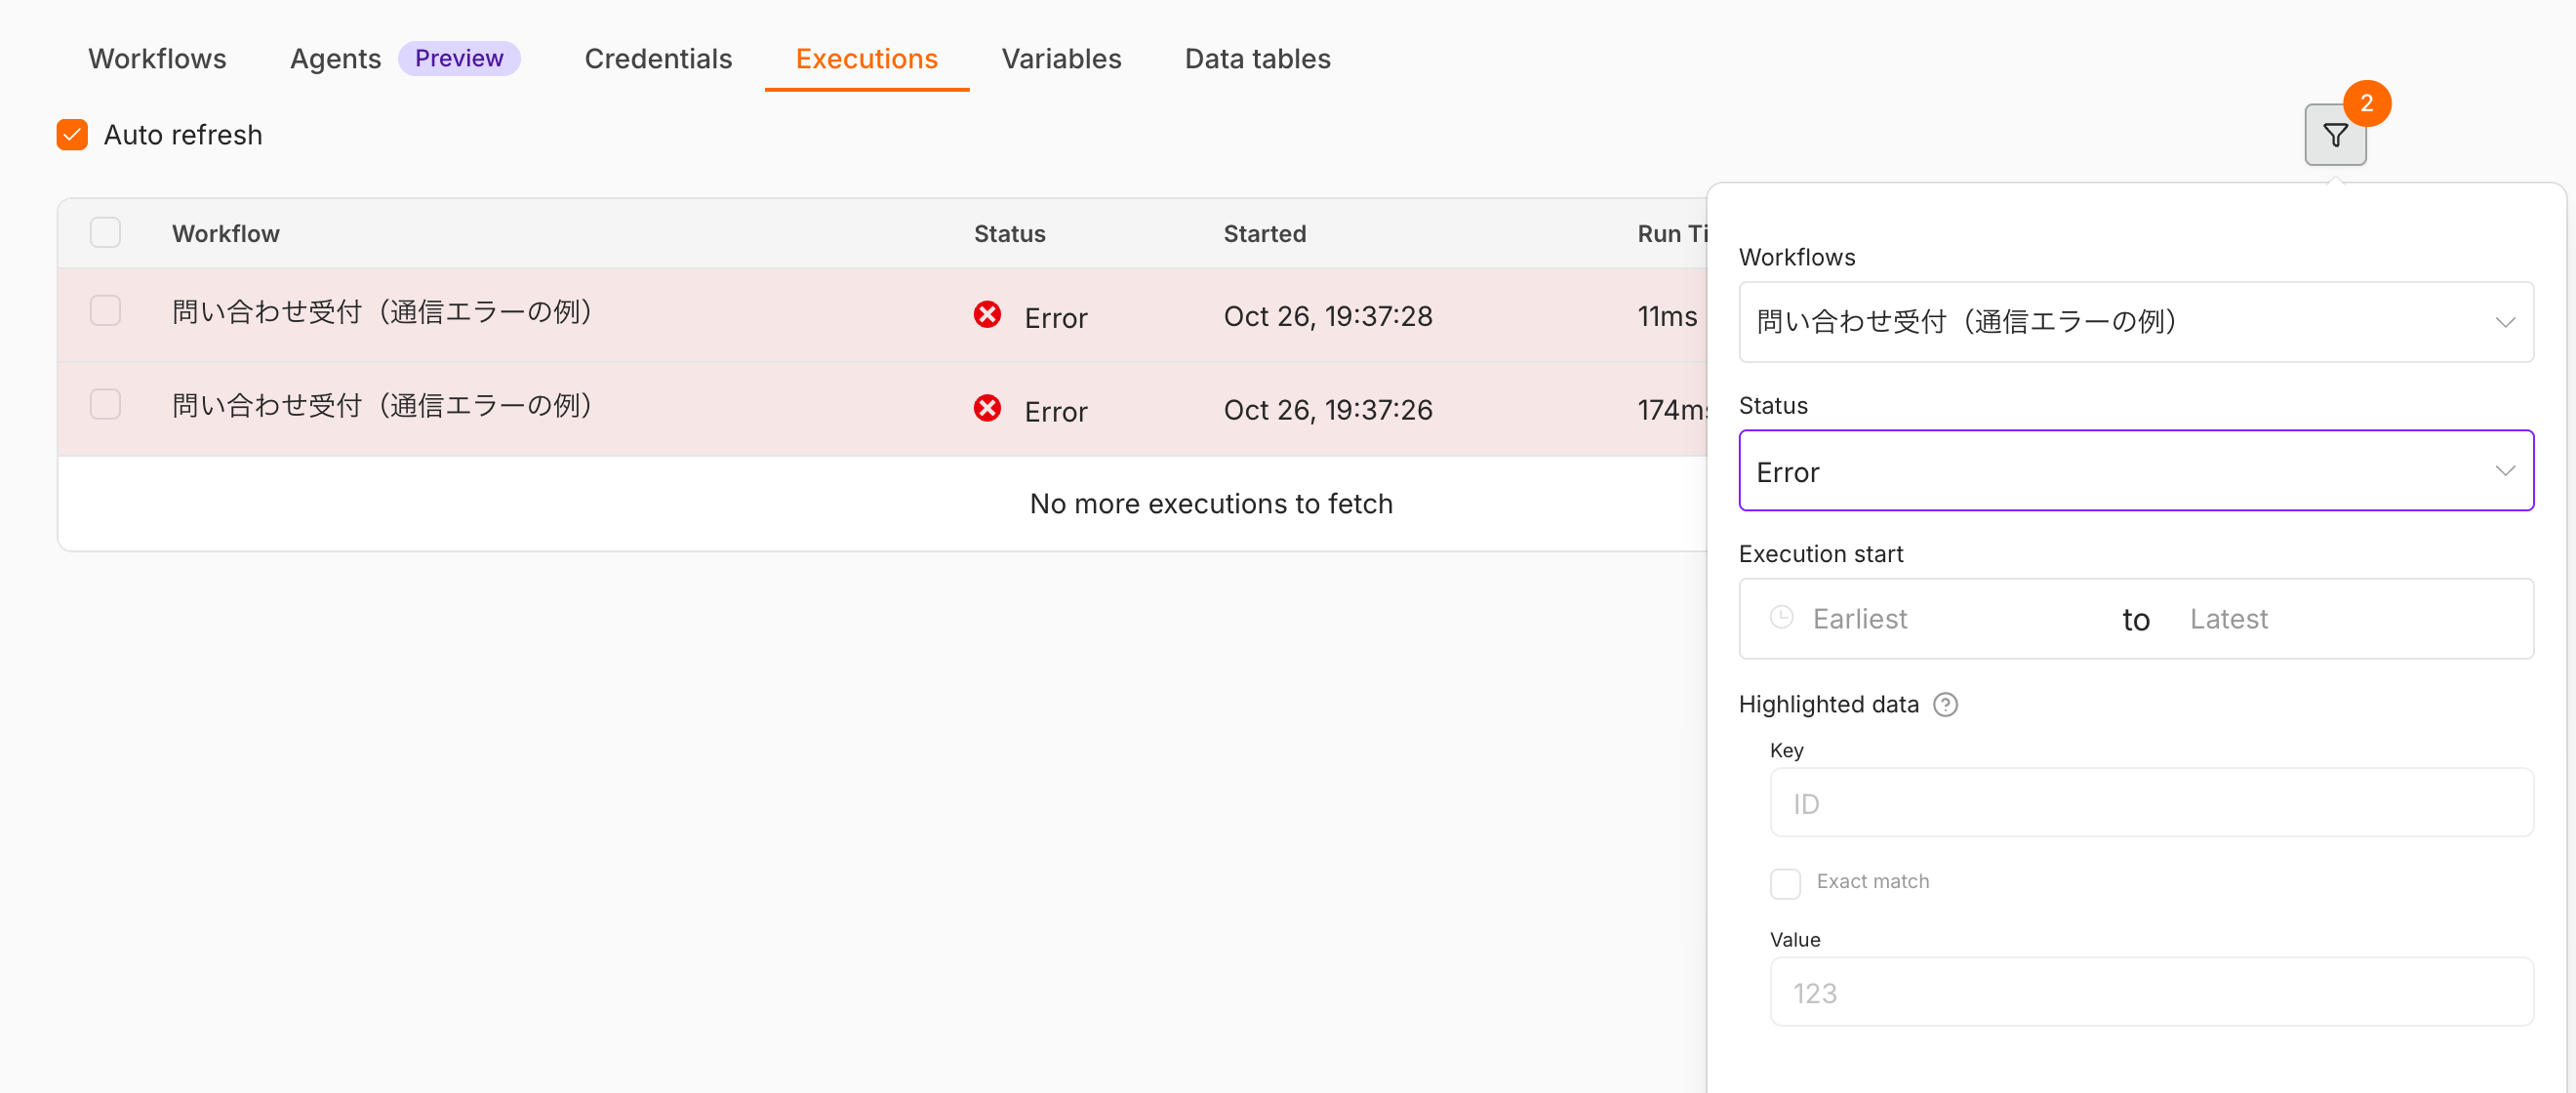
| 毎週 | 「Executions」で Status を「Error」に絞った一覧 | 通知が来ていない失敗があれば Error Workflow の指定漏れを直す |
| 毎週 | Security Advisories | 手順9のとおり動く |
| 毎週 | VPSの外に昨日のバックアップが届いているか | backup.log を読む |
| 毎月 | release notes と1つ上の版 | 手順8で上げる |
| 毎月 | 手元に戻してCredentialが開くか | 手順7 |
| 毎月 | docker system df -v でのボリュームの容量 | 保存する履歴を減らす |
| 毎月 | n8n audit の結果とユーザー一覧 | 使っていないCredentialとユーザーを消す |
応用
誤報を減らす
一時的な失敗まで全部知らせると、#n8n-監視 がまた読まれなくなります。まず失敗しやすいノードの「Settings」で「Retry On Fail」(失敗したらやり直す)を付けます。それでも多いときは、エラー用ワークフローの中で「Wait」ノードを30分置き、同じワークフローがまだ失敗しているかを確かめてから知らせます。実際に本番で動かしていると、この形にしてから夜中の誤報がほとんど無くなりました。
業務の異常もエラーにする
n8nが「成功」と言っても、業務として正しいとは限りません。フォームのデータにメールアドレスが無い、シートに書けた件数が0件、といった場合は「IF」ノードで判定して「Stop and Error」で止めます。業務の異常もエラー用ワークフローへ同じ形で届きます。
監査を毎月自動で流す
セキュリティ監査は「n8n」ノードからも動かせます。Resourceを「Audit」、Operationを「Generate」にし、毎月1日の「Schedule Trigger」につないで結果をSlackへ送ります。このノードはn8nのAPIキーで公開APIを呼ぶので、公開APIを止めていると使えません。
できないことと、その代わり
| できないこと | 代わりの手 |
|---|---|
| n8nが落ちたことをn8nの中で知らせる | 外部の死活監視サービスで /healthz/readiness を見る |
| 手動実行の失敗をエラー用ワークフローで受ける | 定期実行と「Stop and Error」の試験用ワークフローで試す |
| CLIのバックアップだけで丸ごと戻す | データフォルダを丸ごと保存する |
| 無料のセルフホストで2段階認証を全員に強制する | 各自に設定してもらい、毎月のユーザー点検で確かめる |
| 古い版へ番号だけで戻す | 更新前のデータフォルダごと戻す |
| 止まっていた間の定期実行を後から全部流す | 止まっていた時間帯を確かめ、必要な分を手で流す |
よく詰まるところ
| 症状 | 原因 | 直し方 |
|---|---|---|
| 試しにエラーを起こしても通知が来ない | 手動実行の失敗ではError Triggerが動かない | 定期実行で失敗させて試す |
| 通知の「内容」が空 | トリガーで失敗し execution.error が無い | trigger.error も読む式にする |
| 通知に実行の画面のリンクが無い | 失敗した実行を保存しない設定 | 「Save failed production executions」を保存にする |
| 一部のワークフローだけ通知が来ない | 「Error Workflow」が未設定 | 新しく作ったら毎回Settingsで指定する |
| 止まっているのに実行一覧に何も無い | トリガーの起動時に失敗している | 毎朝の生存確認と「Force Reconnect Every Minutes」 |
| 問い合わせが急に来なくなった | 証明書が切れ、フォームからの送信が弾かれている | 証明書を更新し、外部監視に残り日数を足す |
| 履歴を消してもディスクが空かない | SQLiteは消した分を使い回すだけ | 一度だけ詰め直して起動する |
| 戻したデータに直前の変更が無い | WALファイルが抜けている | n8nを止めてフォルダごと保存する |
| 戻したらCredentialが全部開けない | 暗号鍵が本番と違う | 本番と同じ N8N_ENCRYPTION_KEY で起動し直す |
| 再起動したら勝手に版が上がっていた | タグを stable や latest にしている | N8N_VERSION を番号で固定する |
次にやること
まだVPSに立てていないなら「n8nをセルフホストで導入する:Docker ComposeでVPSに立て、独自ドメインとHTTPSで使う」から始めます。自前で運用する手間とCloudの費用を比べるなら「n8nの料金:Cloudとセルフホストの費用、商用利用の線引き」を読みます。エラー用ワークフローの操作に慣れていなければ「n8nの使い方入門:最初のワークフローを作って動かす」で基本を確かめます。外に開ける入口を整理するときは「n8nで外部サービスとつなぐ:Webhook・HTTP Request・API」が役に立ちます。