n8nのAIノードは、下につなぐ Chat Model を差し替えるだけで、OpenAI・Anthropic・Google Gemini・Ollama などのLLMを切り替えられます。この記事は、どのモデルをどの仕事に使い、月にいくらかかるかを決めるためのものです。読み終わると、各社のAPIキーをつなぎ、仕事ごとにモデルを分け、費用の上限まで決めた状態になります。前提は「問い合わせ受付」ワークフローに Text Classifier か AI Agent を置いたことがあることで、置き方は「n8nでAIエージェントを作る:ChatGPT・Claude・Geminiをつなぐ」にあります。画面と設定項目は2026年10月時点の安定版2.44.7で確認しています。
先に決めること
問い合わせの本文を社外に出してよいか
クラウドのLLMを使えば、問い合わせの本文は各社のサーバーに送られます。氏名や電話番号の入った本文を送ってよいかを最初に決めます。だめなら、Ollamaで社内から出さない構成にするか、送る前に伏せます。
誰の契約で払うか
払い方は、各社と直接契約して自社のAPIキーを使う、OpenRouter のような中継サービスにまとめて払う、n8n Cloud の Starter と Pro なら「Gateway credits」(n8n経由の前払いクレジット)で払う、の3つです。Gateway credits の扱いは「n8nの料金:Cloudとセルフホストの費用、商用利用の線引き」にあります。
月の上限額
「月○ドルを超えたら止まってよい」という額を先に決め、各社の管理画面の上限に入れます。止まったときに誰が気づくかも決めます。
各社の比較
n8nには公式のものだけで20種類ほどの Chat Model ノードがあり、ノードの追加パネルの「Language Models」に並んでいます(認定済みのコミュニティノードも一緒に出ます)。よく使うのは次の5つです。
| OpenAI | Anthropic | Google Gemini | Ollama | OpenRouter | |
|---|---|---|---|---|---|
| ノード | OpenAI Chat Model | Anthropic Chat Model | Google Gemini Chat Model | Ollama Chat Model | OpenRouter Chat Model |
| 認証情報 | OpenAI | Anthropic | Google Gemini(PaLM) Api | Ollama | OpenRouter |
| 認証情報に入れるもの | API Key(組織が複数なら Organization ID も) | API Key | API Key(Host は既定のまま) | Base URL | API Key |
| 追加したときの既定のモデル | gpt-5-mini | Claude Sonnet 5 | gemini-3-flash-preview | llama3.2 | openai/gpt-4.1-mini |
| AI Agent で使えるか | 使える | 使える | 使える | ツール対応のモデルなら | 選んだモデル次第 |
| 費用 | トークン従量 | トークン従量 | 無料枠あり。業務は有料枠 | マシン代のみ | 元の会社の単価+購入手数料 |
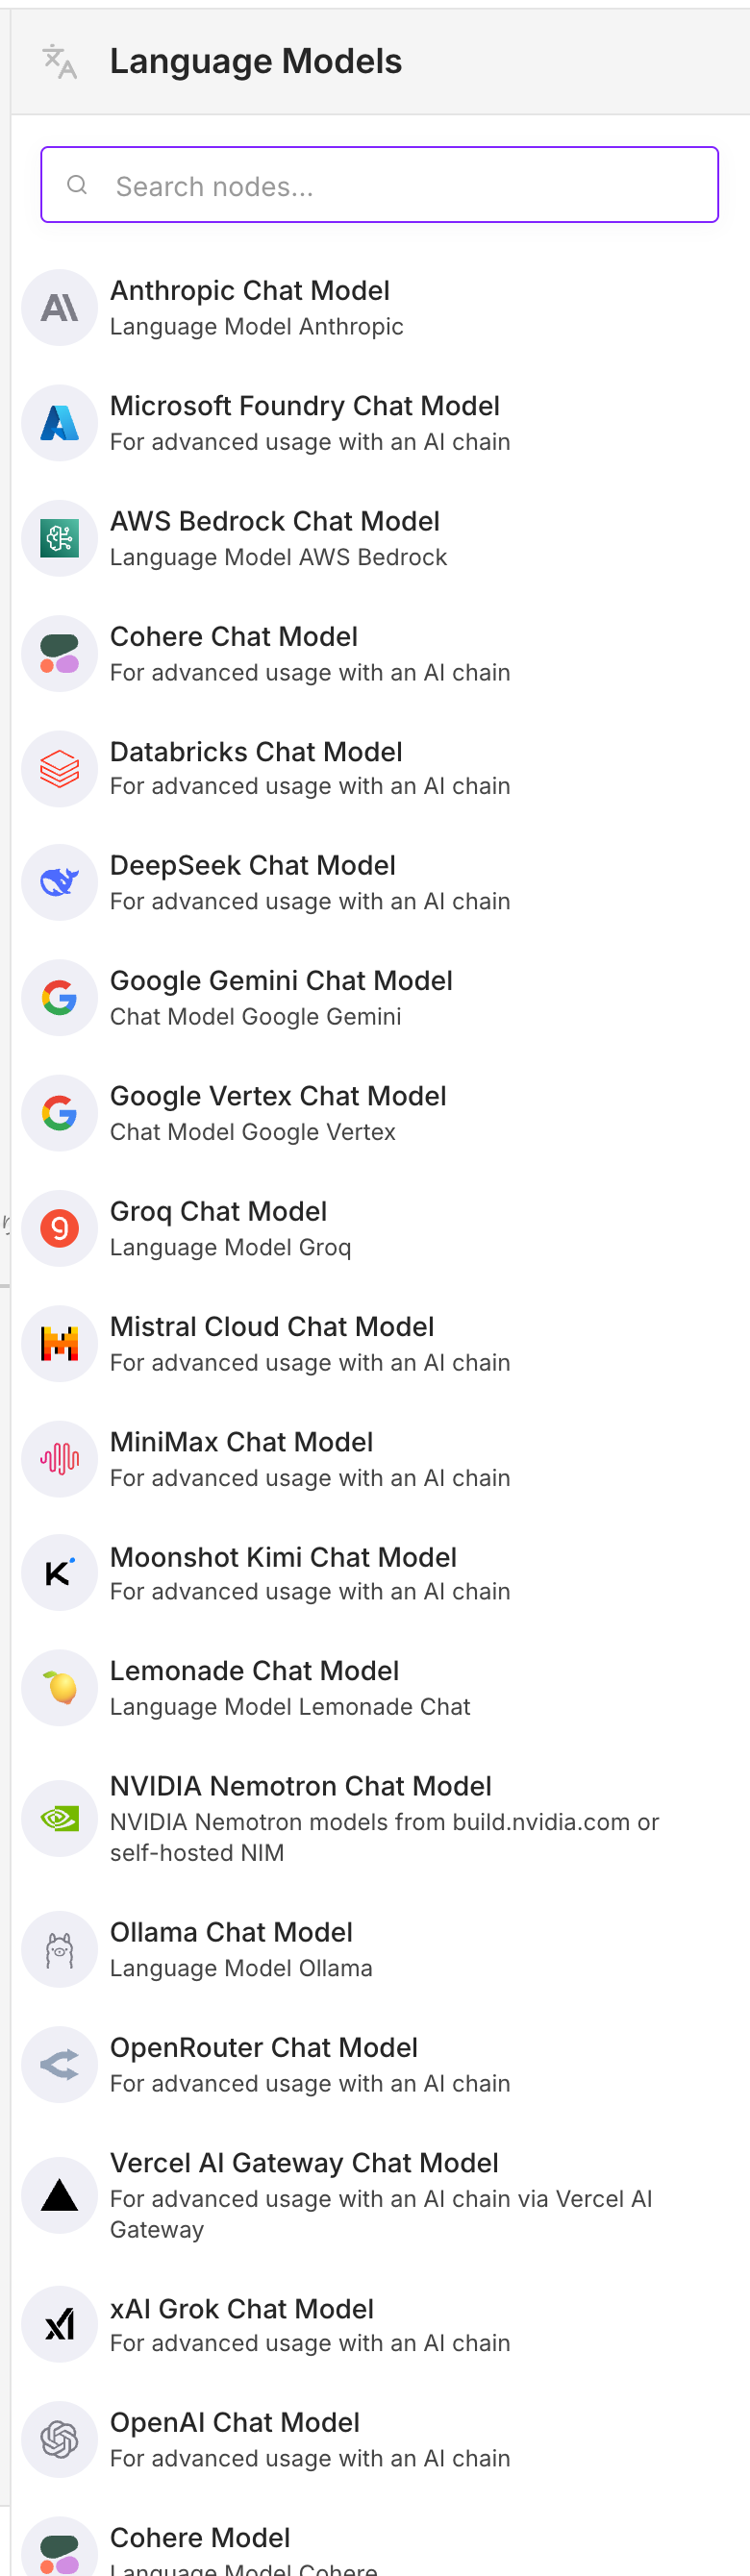
AI Agent は、つないだモデルがツール呼び出しに対応していないと動きません。公式の Tools Agent のページが対応として挙げるのは OpenAI・Anthropic など5つで、Gemini・Ollama・OpenRouter は載っていませんが、2.44.7 のノードではどれも AI Agent につなげます。引っかかるのは Ollama と、OpenAI互換の別サービスにつないだときです。
データの扱い(2026年10月時点の各社の公式の記述)
| 送った内容が学習に使われるか | 補足 | |
|---|---|---|
| OpenAI | 使われない(明示的にオプトインした場合を除く) | 不正利用の監視のため最大30日保存される |
| Anthropic | Anthropic API などの商用製品は既定で使われない | フィードバックを送った場合などは例外 |
| Google Gemini | 無料枠は使われる。有料枠は使われない | 無料枠は人が読むことがあり、規約に機密や個人情報を送らないようにとある |
| Ollama | 手元で動かす限り、Ollama 社にプロンプトは見えない | 自社で完結する |
| OpenRouter | 既定ではプロンプトと応答を記録しない | 送り先は既定でデータを集める会社も含む。Data Collection で絞れる(後述) |
Gemini の有料枠は、APIキーを作った Google Cloud プロジェクトに請求先アカウントを紐づけた状態のことです。問い合わせの本文を流すなら有料枠にします。キーはそのまま使えます。
日本語
振り分け・要約・返信の下書きなら、クラウドの3社はどれも、実際に運用していて日本語で困ることはありません。Anthropic は公式の多言語のページで、日本語の成績を英語比で Claude Sonnet 4.5 が96.8%、Claude Haiku 4.5 が93.5%と出しています(現行の Sonnet 5 の数字ではありません)。差が出るのは Ollama の小さいモデルで、n8nの既定の llama3.2 は公式の対応言語に日本語が入っていません。「100以上の言語」とうたう qwen3 のような多言語のモデルから選び、実際の問い合わせで試します。
費用の目安の見方
料金の例(2026年10月時点・標準の単価・100万トークンあたり・USD)
| 会社 | モデル | 入力 | 出力 | 補足 |
|---|---|---|---|---|
| OpenAI | gpt-5-nano | $0.05 | $0.40 | |
| OpenAI | gpt-5-mini | $0.25 | $2.00 | n8nの既定 |
| OpenAI | gpt-6.1-sol | $2.00 | $10.00 | |
| Anthropic | Claude Haiku 5.5 | $0.10 | $0.50 | 入力10万トークン以下のとき(超えると $0.50/$2.50) |
| Anthropic | Claude Sonnet 5 | $2 | $10 | n8nの既定 |
| Anthropic | Claude Opus 5.5 | $4 | $20 | |
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | 有料枠 | |
| Gemini 3 Flash Preview | $0.50 | $3.00 | n8nの既定。有料枠 | |
| Gemini 3.1 Pro Preview | $2.00 | $12.00 | 入力20万トークン以下のとき。無料枠なし |
単価はこの先も変わるので、決める前に各社の公式の料金ページで確かめます。
計算のしかた
1回の費用は「入力トークン数 × 入力単価 ÷ 100万」と「出力トークン数 × 出力単価 ÷ 100万」の合計です。入力には本文だけでなく、指示文、カテゴリの説明、会話の履歴、AI Agent ならツールの説明と結果まで入ります。
仮に、Text Classifier での振り分けが1件あたり入力1,500トークン・出力50トークンで、月300件来るとします。月の入力は45万トークン、出力は1.5万トークンです。
| モデル | 月の費用(2026年10月時点の単価) |
|---|---|
| Gemini 2.5 Flash-Lite | 約$0.05 |
| gpt-5-mini | 約$0.14 |
| Claude Sonnet 5 | 約$1.05 |
| Claude Opus 5.5 | 約$2.10 |
社内チャットの AI Agent で、1回の質問にLLMを4回呼び、1回あたり入力4,000・出力200トークンなら、月400回で入力640万・出力32万トークンです。2026年10月時点の単価なら gpt-5-mini で約$2.24、Claude Sonnet 5 で約$16、Claude Opus 5.5 で約$32です。エージェントにすると桁が変わります。
さらに、考える機能(推論・Thinking)を使うと、考えた分も出力として課金されます。Anthropic の料金ページには、Claude 4.7以降は同じ文章でも約30%多いトークンに数えるとあります。机上の計算は外れるので、実際に流して数えます。
実際のトークン数を見る
- 問い合わせ受付を、過去の問い合わせ10件ほどで手動実行する。
- 実行後、Chat Model のサブノードを開く。
- 出力欄に出る「○○ Tokens」と、内訳の「Prompt:」(入力)「Completion:」(出力)を控える。
- 10件の平均に月の件数を掛け、上の式に入れる。
- 1週間動かしたら、各社の管理画面の使用量のページで実額と照らし合わせる。n8nに金額は出ない。
各社の Chat Model をつなぐ
どの会社も、APIキーを作る、n8nの認証情報(Credential)に貼る、Chat Model をつないでモデルを選ぶ、の3段です。認証情報の共有や権限は「n8nの認証情報(Credential):OAuth2・APIキー・共有と権限」にあります。
共通の手順
- 「Overview」の「Credentials」タブで「Create credential」を押す。
- 「Add new credential」の検索欄に会社名(例:Anthropic)を打って選び、「Continue」を押す。
- APIキーを「API Key」に貼って「Save」を押し、接続テストが通ることを確かめる。
- 問い合わせ受付の Text Classifier(または AI Agent)の下の「+」から、その会社の Chat Model を追加する。
- 「Credential」で手順3の認証情報を選ぶ。
- 「Model」の一覧から選ぶ。一覧は各社から読み込むので、自社のアカウントで使えるモデルだけが出る。
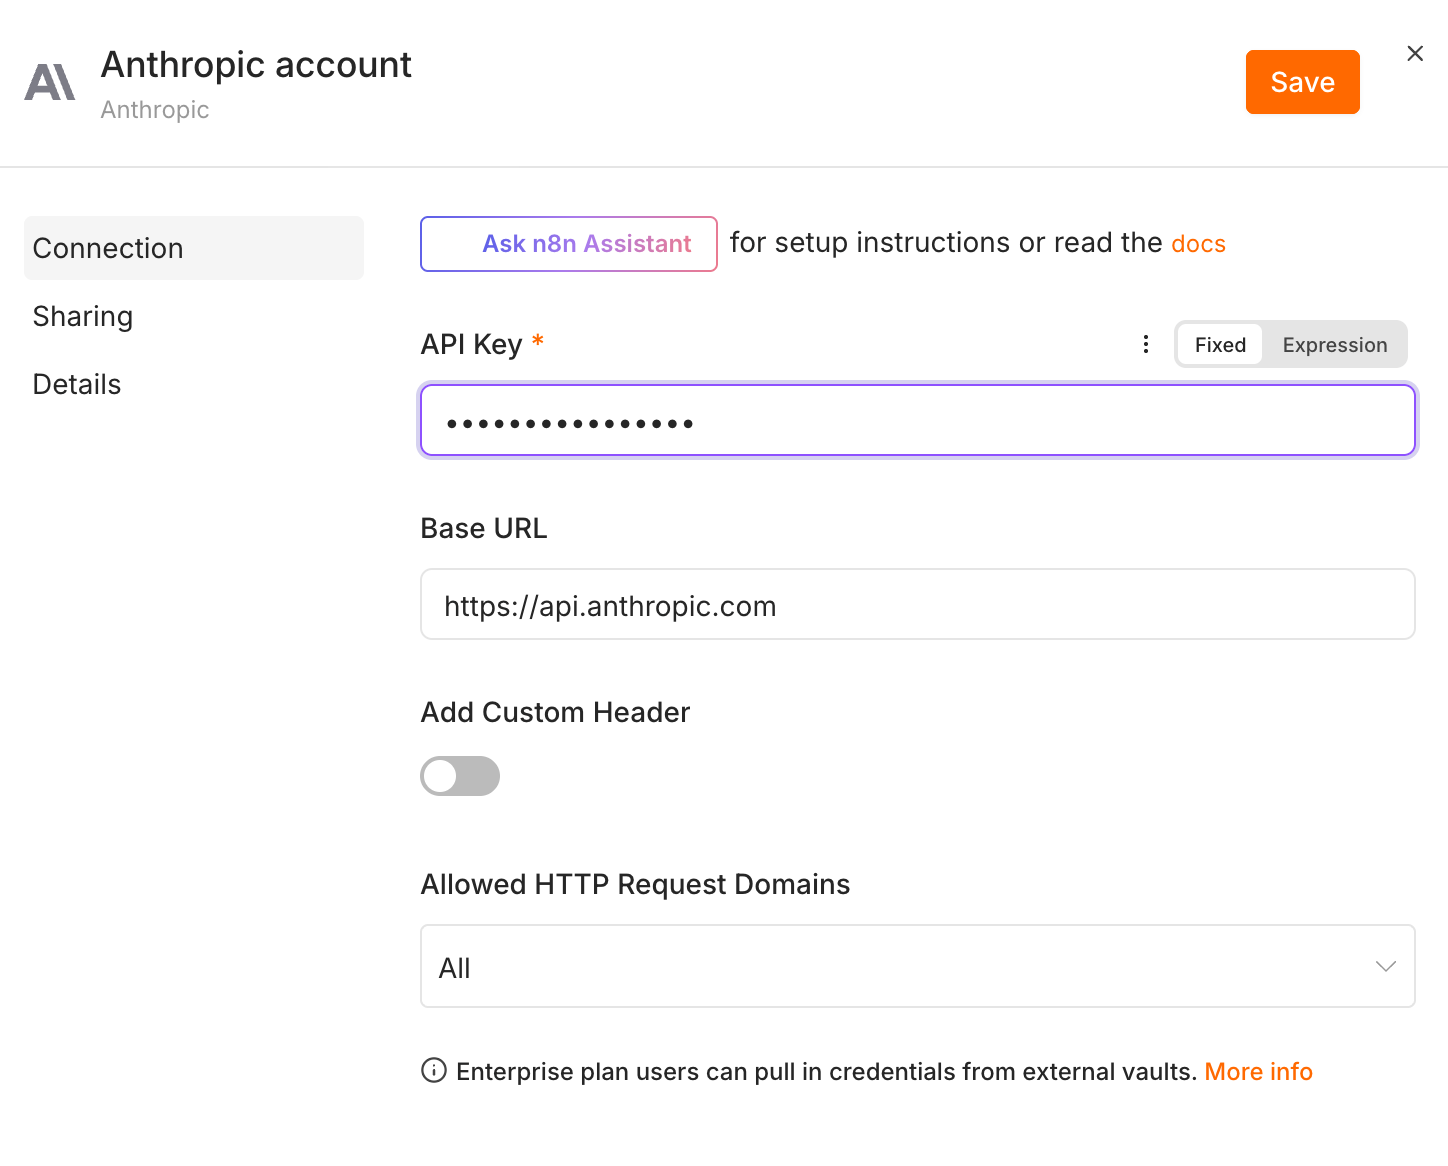
APIキーは「n8n-問い合わせ受付」「n8n-社内チャット」のように用途ごとに作ります。使いすぎたワークフローがすぐわかり、片方だけ止められます。
OpenAI(ChatGPT)
ChatGPT の有料プランとAPIは別の契約で、n8nから使うにはAPIの支払い設定が要ります。
- OpenAIのAPIの管理画面にログインし、「API keys」のページで「Create new secret key」を押す。
- キーを OpenAI の認証情報の「API Key」に貼る。
- 複数の組織に入っている場合だけ、組織の設定ページの Organization ID を「Organization ID (optional)」に入れる。
「Use Responses API」は、2.44.7では追加した時点でオンです(公式のページは既定オフと書いていますが、実装はオンでした)。オフにすると「Service Tier」と「Built-in Tools」(Web Search など)は出ません。Built-in Tools は AI Agent と組み合わせたときだけ動きます。
費用に効く「Options」は次の4つです。
| Option | 既定 | 決め方 |
|---|---|---|
| Maximum Number of Tokens | -1(上限なし) | 振り分けなら500程度、返信の下書きなら2,000程度に決める |
| Reasoning Effort | Medium | gpt-5系などで出る。振り分けは Low で足りる |
| Service Tier | Auto | Flex にすると Batch と同じ単価になる代わりに遅く、混んでいると断られる |
| Timeout | 60000(ミリ秒) | Flex にするなら延ばす |
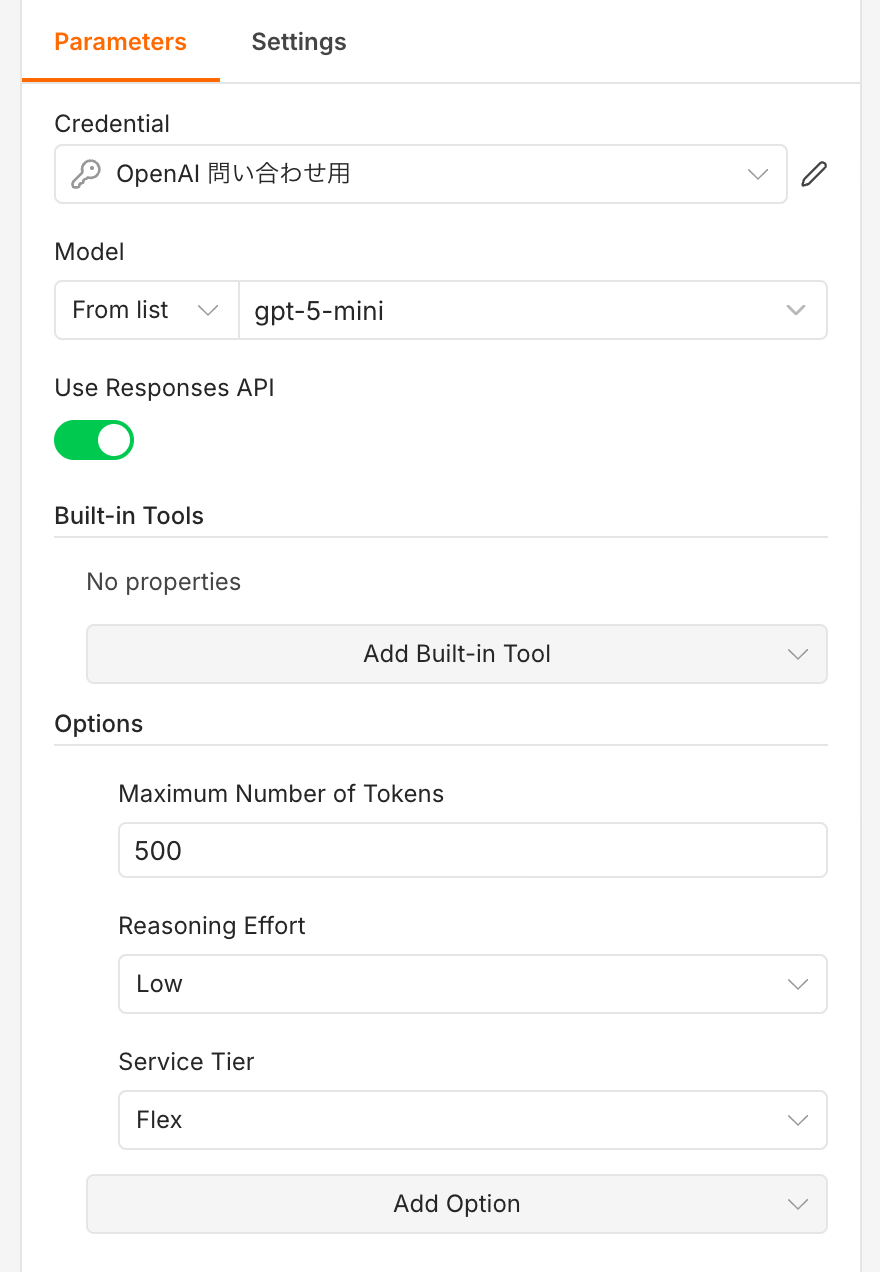
Maximum Number of Tokens には考える分のトークンも含まれ、小さすぎると答えが空になります。OpenAI の推論のガイドは、試す段階では2万5,000トークン以上を空けるよう勧めています。上限なしで流して実数を見てから絞ります。
Anthropic(Claude)
- Anthropic Console の「Settings > API Keys」を開き、「+ Create Key」を押す。
- 名前を付けて作り、「Copy Key」でコピーする。
- n8nの Anthropic の認証情報の「API Key」に貼る。
先にConsoleでクレジットを入れておきます。Model の既定は Claude Sonnet 5 です。
| Option | 既定 | 決め方 |
|---|---|---|
| Maximum Number of Tokens | 4096 | 振り分けなら小さくする |
| Thinking Mode | 足さなければモデルの既定。足すと Disabled | Adaptive (Recommended) にすると Effort で考える量を決められる。振り分けには要らない |
| Prompt Caching | Disabled | 長い指示文を何度も送るなら 5 Minutes か 1 Hour |
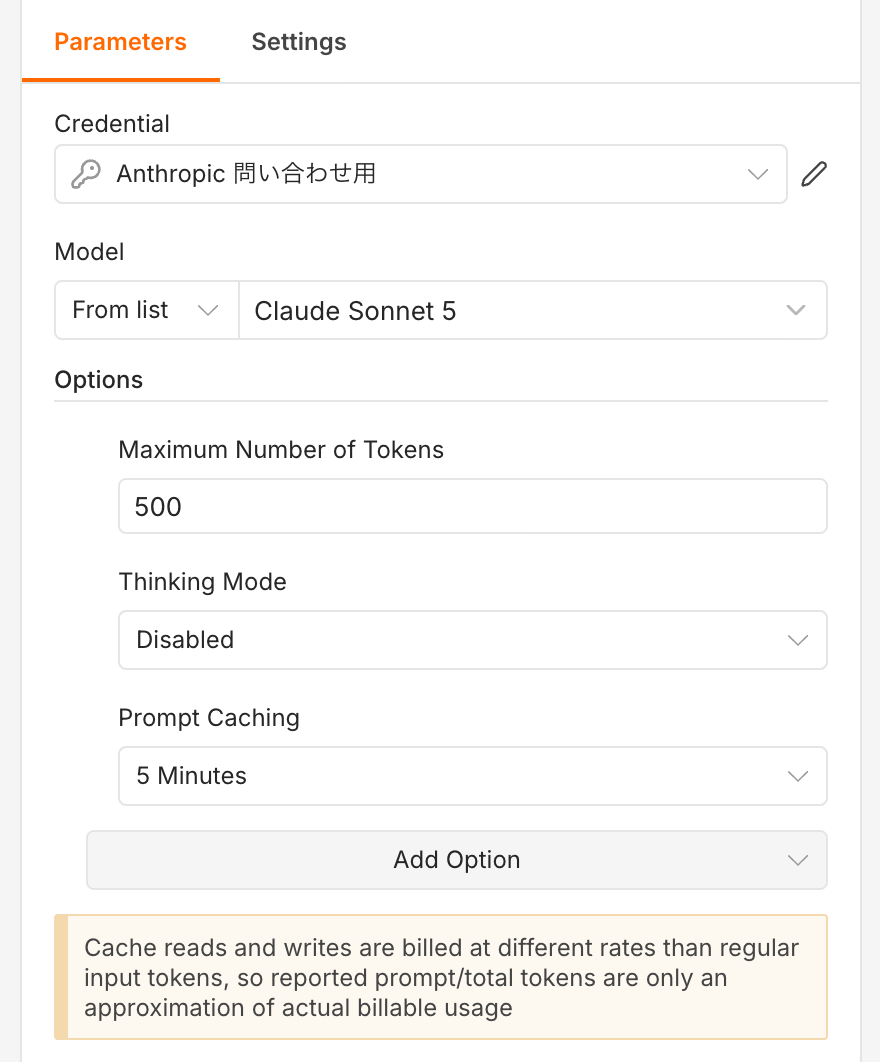
Prompt Caching は、同じ指示文やツールの説明を続けて送るときに2回目以降の入力を安くします。公式の料金ページでは、読んだ分は通常の入力の1割(一部のモデルはさらに安い)、書き込みは5分なら1.25倍、1時間なら2倍です。社内チャットで長い System Message を使うときに効き、1日数件の問い合わせでは書き込み代のほうが高くつきます。
Google Gemini
- Google AI Studio の API Key のページで「Create API Key」を押す。新しいプロジェクトに作るか、既存の Google Cloud プロジェクトに作るかを選ぶ。
- キーを「Google Gemini(PaLM) Api」の認証情報の「API Key」に貼る。「Host」は既定のまま。
- 業務で使うなら、AI Studio の Projects のページで、そのプロジェクトの「Set up billing」を押して有料枠にする。
Model の既定の gemini-3-flash-preview は、Google の料金ページでは旧世代の Flash とされているので、一覧から選び直します。「Maximum Number of Tokens」の既定は2048で、長い返信の下書きは途中で切れることがあります。無料枠の回数の上限は AI Studio で見られます。
OpenRouter
OpenRouter は、各社のモデルを1つのAPIキーで呼べる中継サービスです。公式には、単価は元の会社のままで、クレジットを買うときに手数料がかかるとあります。
- OpenRouter のAPIキーのページで「Create new secret key」を押す。
- n8nの OpenRouter の認証情報の「API Key」に貼る。
- OpenRouter Chat Model の「Model」で、
anthropic/やgoogle/で始まる名前から選ぶ。
データの扱いを絞るなら、「Options」の「Provider Routing」を足し、既定で Allow の「Data Collection」を Deny にします。データを集めない送り先にだけ流れます。新しいモデルを試すときに便利ですが、各社の管理画面の上限は使えず、上限は買ったクレジットの残高になります。
Ollamaで手元のモデルを使う
Ollama は、公開されているモデルを自社のマシンで動かす道具です。本文を社外に出さず、トークンの課金もない代わりに、マシンの性能が要ります。
どこに置くか
| 置き場所 | 向く場面 | 注意 |
|---|---|---|
| 手元のMacやPC | 試す | Mac の Docker Desktop はGPUを使えないので、Ollama はアプリのまま動かす |
| n8nと同じ月額1,000〜2,000円台のVPS | 向かない | メモリが足りず、1件に数十秒かかることもある |
| GPU付きのサーバー | 本番 | n8nと同じ compose.yaml に入れられる |
| 社内のGPU付きPC | 社外に一切出したくない本番 | VPSのn8nから届く経路(VPNなど)が要る |
手元で n8n ごと試すときの入れ方は「n8nを手元のPCで動かす:Mac・WindowsにnpxとDocker Desktopで入れる」にあります。
n8nと同じ compose.yaml で動かす
「n8nをセルフホストで導入する:Docker ComposeでVPSに立て、独自ドメインとHTTPSで使う」で作った compose.yaml の services: に ollama を足します。ポートは外に出しません。Docker Compose は同じファイルのサービス同士をサービス名で呼べるので、n8nからは http://ollama:11434 で届きます。
services:
  ollama:
    image: ollama/ollama
    restart: always
    volumes:
      - ollama_data:/root/.ollama

volumes:
  ollama_data:
NVIDIAのGPUを使うなら NVIDIA Container Toolkit を入れ、ollama に GPU の割り当てを足します。
- compose.yaml を保存し、
docker compose up -d ollamaで起動する。 - 使うモデルを取り込む。
- n8nで「Create credential」から「Ollama」を選び、「Base URL」に
http://ollama:11434を入れて保存する。 - Text Classifier の下に「Ollama Chat Model」をつなぎ、「Model」で取り込んだモデルを選ぶ。
docker compose exec ollama ollama pull qwen3:8b
docker compose exec ollama ollama list
「API Key」は、Open WebUI のような認証付きのプロキシを挟むときだけ使う欄なので空のままです。11434番はインターネットに開けません。
n8nは Docker、Ollama はホストで動かす
Ollama をホストに直接入れた場合、n8nのコンテナから見た localhost はコンテナ自身なので届きません。
sudo systemctl edit ollama.serviceを開き、[Service]の下にEnvironment="OLLAMA_HOST=0.0.0.0:11434"を書いて保存する。sudo systemctl daemon-reloadとsudo systemctl restart ollamaで反映する。- compose.yaml の
n8nに次のextra_hostsを足す。Docker Desktop なら不要。 - 認証情報の「Base URL」を
http://host.docker.internal:11434にする。 - VPSのファイアウォールで11434番を開けていないことを確かめる。
  n8n:
    extra_hosts:
      - "host.docker.internal:host-gateway"
手順5を飛ばすと、外から誰でも使えます。
Ollama のモデルを選ぶ
「Model」の一覧は、Ollama に取り込み済みのモデルを読み込んで出します。取り込む前は空です。
- AI Agent で使うなら、ollama.com のモデルのページに「tools」の印があるモデルを選ぶ。llama3.2 と qwen3 には付いている
- 大きいモデルほど賢いが、ダウンロードの大きさ以上のメモリが要る(qwen3 の 8b は約5.2GB)
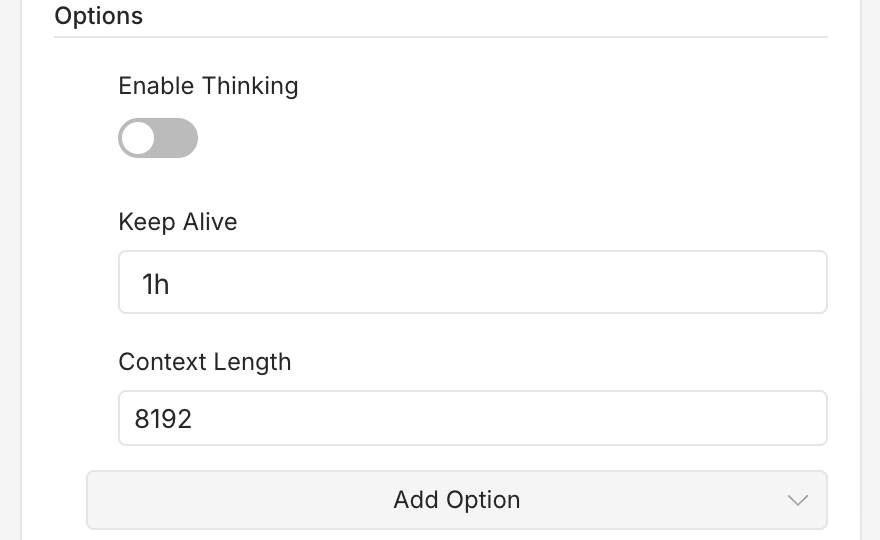
Options の次の3つは必ず見直します。
| Option | 既定 | 決め方 |
|---|---|---|
| Context Length | 2048(足したとき) | 長文や AI Agent では8192以上にする。足さないと Ollama の既定(公式FAQでは4096)になり、超えた分は黙って捨てられる |
| Enable Thinking | オン | 対応モデルで考える過程を分けて出す。振り分けでは時間がかかるだけなのでオフにする |
| Keep Alive | 5m | モデルをメモリに置いておく時間。間隔が空くと毎回読み込みから始まるので、日中は 1h などにする |
費用を抑える設定
仕事ごとにモデルを分ける
問い合わせ受付で上位のモデルが要る場面はほとんどありません。
| 仕事 | 選ぶモデルの格 | 例 |
|---|---|---|
| 種類の振り分け、項目の抜き出し | 一番安い格 | gpt-5-nano、Claude Haiku 5.5、Gemini 2.5 Flash-Lite |
| 要約、返信の下書き | 中くらい | gpt-5-mini、Gemini 3 Flash 系 |
| 社内チャットの AI Agent、資料を読ませる回答 | 中くらい〜上位 | Claude Sonnet 5、gpt-6.1-sol |
| 契約書の確認のような重い判断 | 上位 | Claude Opus 5.5。そもそも人が見る前提にする |
過去の問い合わせ20件を安いモデルと上位のモデルに流してシートに並べ、正解率が同じなら安いほうに決めます。
条件でモデルを切り替える(Model Selector)
長い問い合わせだけ上位のモデルに回すなら、Model Selector を使います。
- Text Classifier の「Model」の「+」から「Model Selector」を追加する。
- 「Number of Inputs」を2にする。
- Model Selector の下の Model 1 に安いモデル、Model 2 に上位のモデルをつなぐ。
- 「Rules」で「Add Rule」を押し、「Model」を Model 2 にする。「Conditions」の左に
{{ $json.body.message.length }}、比較を Number の「is greater than」、右に2000を入れる。 - もう1つルールを足し、「Model」を Model 1 にして、同じ式が「is less than or equal to」
2000の条件にする。
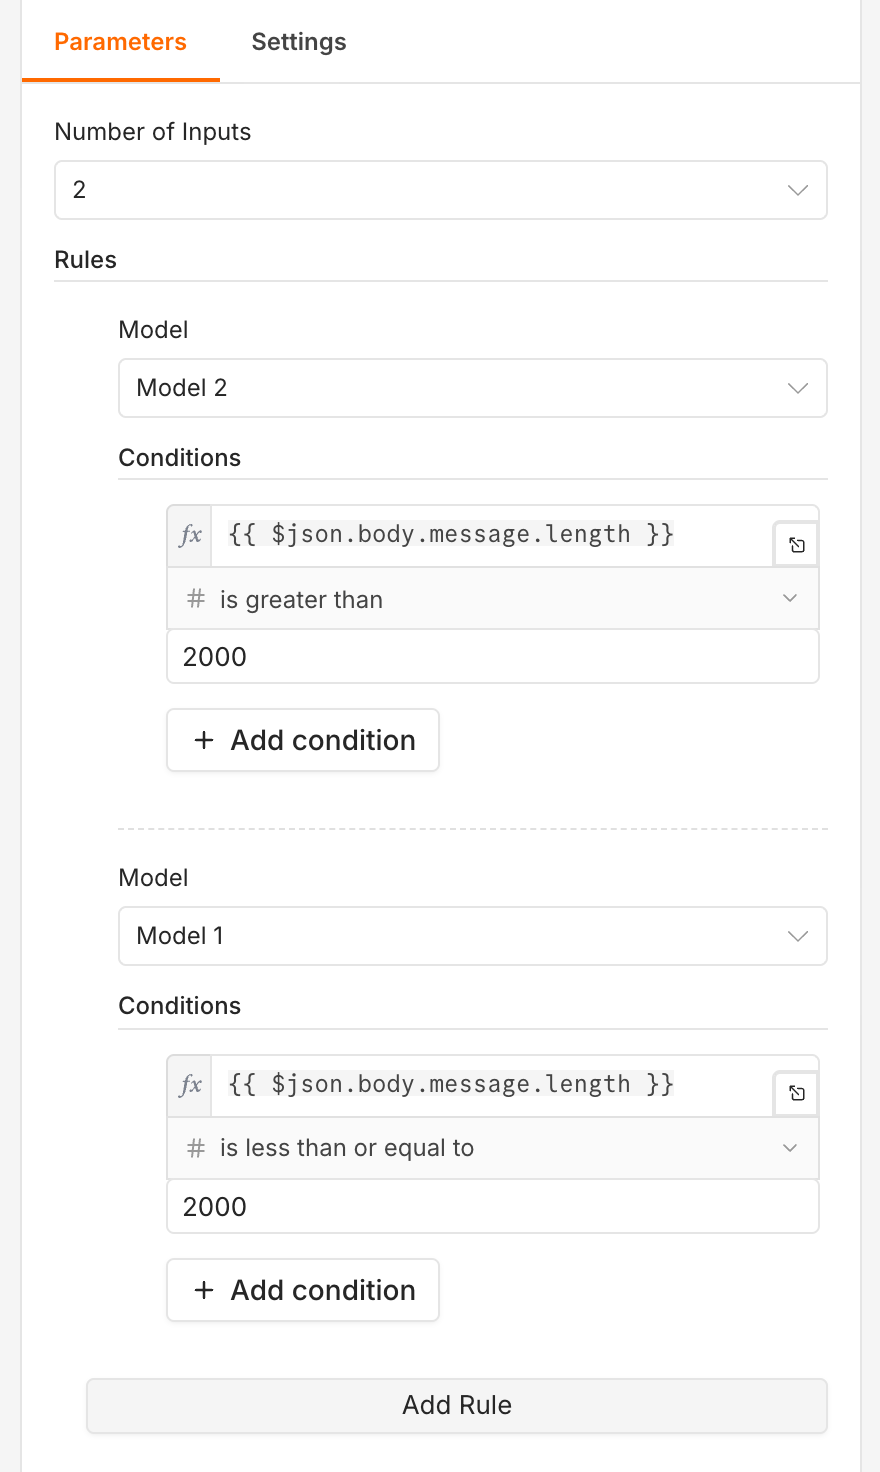
ルールは上から見て、最初に合ったものだけを使います。どれにも合わないと「None of the defined rules matched the workflow data」で止まるので、手順5の受け皿は必ず作ります。式は常に1件目の項目で評価されるので、複数件をまとめて流すと全部が1件目の判定になります。
最大トークンを決める
OpenAI と OpenRouter の既定は上限なしです。LLMが同じ文を繰り返し始めると、そのまま出力の課金が積み上がります。仕事ごとに上限を入れます。
ループで呼びすぎない
- シートの全行を Loop Over Items で回して1行ずつLLMに渡す組み方は避ける。先に IF や Filter で「未対応」かつ「種類が空」の行に絞ってから渡す
- Text Classifier・Basic LLM Chain・Information Extractor の Options の「Batch Processing」で「Batch Size」と「Delay Between Batches」を決め、まとめて流すときのレート制限を避ける
- AI Agent の「Max Iterations」(既定10)を必要な数まで下げる
- 「Retry On Fail」の再試行も課金される。「Max. Tries」は2〜3にとどめる
- 組んでいる最中は、LLMのノードの出力を「Pin data」で固定して後ろを組む。テストのたびにLLMを呼ばずに済む(ピン留めは「n8nの使い方入門:最初のワークフローを作って動かす」にあります)
各社の管理画面で上限を入れる
n8nには費用の上限を決める機能がありません。各社の側で止めます。
| 会社 | 上限の場所 | 上限に達したとき |
|---|---|---|
| OpenAI | Project settings の「Limits」の Spend で「Edit spend limit」、「Enforce a hard limit」をオン | 429(project_spend_limit_exceeded)で翌月まで止まる |
| Anthropic | Console の Billing の「Spend limits」で「Set limit」 | 自分で決めた上限なら You have reached your specified API usage limits で止まる |
| Google Gemini | AI Studio の「Spend」のページの「Monthly spend cap」(試験提供) | 反映が10分ほど遅れ、少し超えることがある。無料枠は回数の上限で 429 |
| OpenRouter | 買ったクレジットの残高まで | 残高がなくなると止まる |
止まったら Slack に知らせるエラーワークフローの作り方は「n8nを止めずに運用する:アップデート・バックアップ・エラー通知・脆弱性」にあります。
応用
片方の会社が落ちたら別の会社で動かす
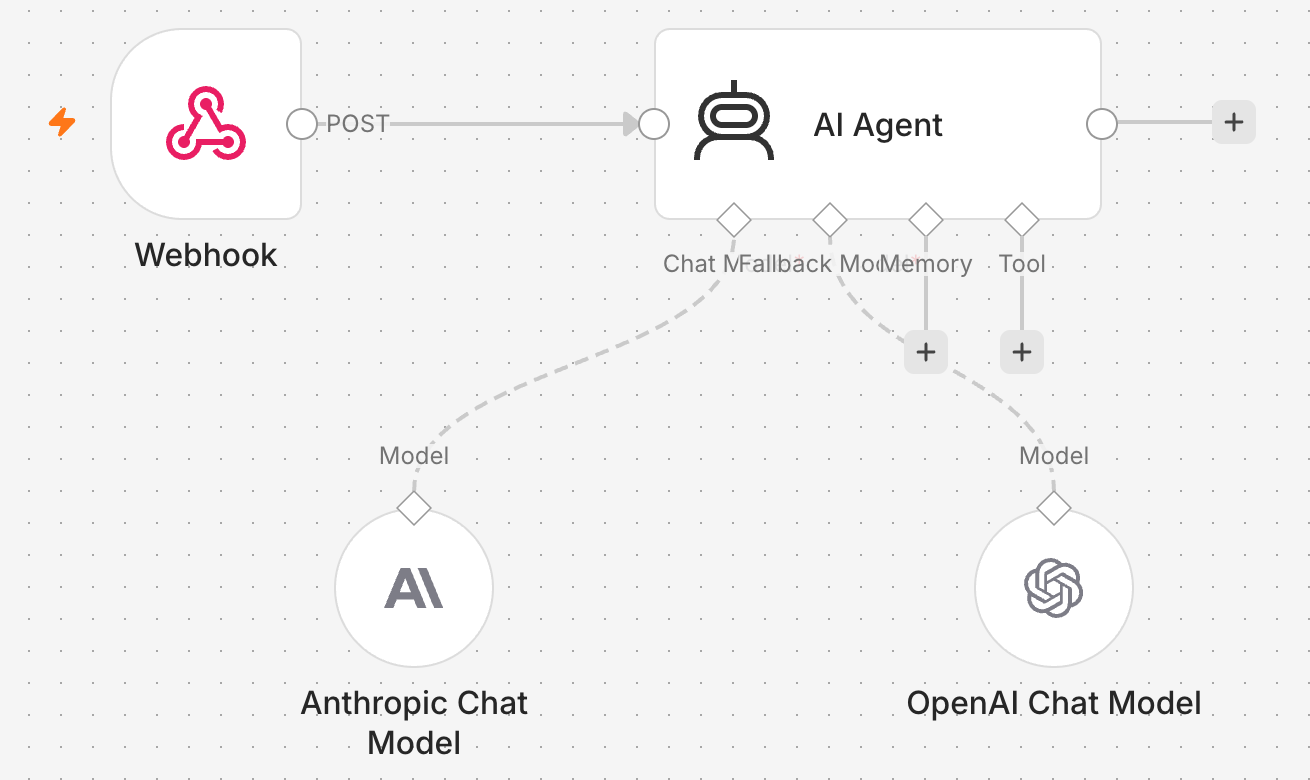
AI Agent と Basic LLM Chain には「Enable Fallback Model」があります。オンにするとノードの下に「Fallback Model」の口が増え、メインのモデルが失敗したときにそちらで動きます。メインを Anthropic、予備を OpenAI のように会社を分けておくと、片方の障害やレート制限で問い合わせ受付が止まりません。
OpenAI互換のAPIを持つサービスにつなぐ
OpenAI の認証情報の「Base URL」を書き換えると、同じ形のAPIを持つ別のサービスにつなげます。ツール呼び出しに対応しないモデルもあり、DeepSeek・xAI Grok・Mistral・Groq などは専用のノードを使います。
できないことと、その代わり
| できないこと | 代わりの手 |
|---|---|
| n8nの中で月の費用の上限を決める | 各社の管理画面で上限を入れ、APIキーを用途ごとに分ける |
| ノードから各社の Batch(半額のまとめ処理)を使う | OpenAI なら Service Tier を Flex にして近い単価にする。本当に Batch を使うなら HTTP Request で各社のAPIを直接呼ぶ |
| Text Classifier や Information Extractor に予備のモデルを付ける | Fallback Model は AI Agent と Basic LLM Chain だけ。ほかのノードは「Settings」の「On Error」を「Continue (using error output)」にし、エラーの出口に別会社のモデルの同じノードを置く |
| 月額1,000〜2,000円台のVPSで Ollama を実用の速さで動かす | GPU付きのサーバーか社内のPCに分けるか、クラウドのLLMにする |
| 学習に使われないことを n8n 側で保証する | 各社の規約で決まる。Gemini は有料枠にする。OpenRouter は Data Collection を Deny にする |
よく詰まるところ
| 症状 | 原因 | 直し方 |
|---|---|---|
| 「Tools Agent requires Chat Model which supports Tools calling」 | AI Agent につないだモデルがツール呼び出しに対応していない | Ollama なら「tools」の印のあるモデルに替える。OpenAI互換のBase URLなら対応モデルを選ぶ |
| Ollama Chat Model の「Model」の一覧が空 | Ollama にモデルを取り込んでいない | ollama pull で取り込んでから開き直す |
| Ollama が長い問い合わせの後半を無視する | Context Length が小さく、超えた分が捨てられている | Options の「Context Length」を上げ、メモリの余裕を見る |
| OpenAI の答えが空になる | Maximum Number of Tokens が小さく、推論で使い切った | 上限を上げるか、「Reasoning Effort」を Low にする |
| OpenAI で JSON を選ぶとエラーになる | JSON Object の形式は、指示文に「json」という語が要る | 指示文に「json」を入れるか、JSON Schema の形式にする |
Gemini で試していると 429 が続く | 無料枠の回数の上限 | AI Studio で上限を確かめ、支払いを設定して有料枠にする |
Claude で You have reached your API usage limits | 利用段階ごとの月の上限に達した | Console の「Rate limits」のページで上の段階を申請する。申請しないと翌月1日の日本時間9時まで止まる |
| Claude で温度を0にしても答えが揺れる | Claude Opus 4.7以降・Claude Sonnet 5以降は Sampling Temperature が効かない | 指示文と出口の形で揺れを抑える |
| 計算より費用がずっと高い | エージェントの繰り返し、会話の履歴、ツールの説明、考えた分のトークンが入力と出力に乗っている | Chat Model の Tokens を見て、Max Iterations・Context Window Length・Thinking を見直す |
次にやること
- n8nでAIエージェントを作る:ChatGPT・Claude・Geminiをつなぐ
- n8nでRAGを作る:社内資料を検索して答えるチャット
- n8nの料金:Cloudとセルフホストの費用、商用利用の線引き
- n8nのMCP:ワークフローを外から呼び出す、外のMCPを使う