生成AIのリスクと対策|情報漏えい・著作権・誤った回答への備え
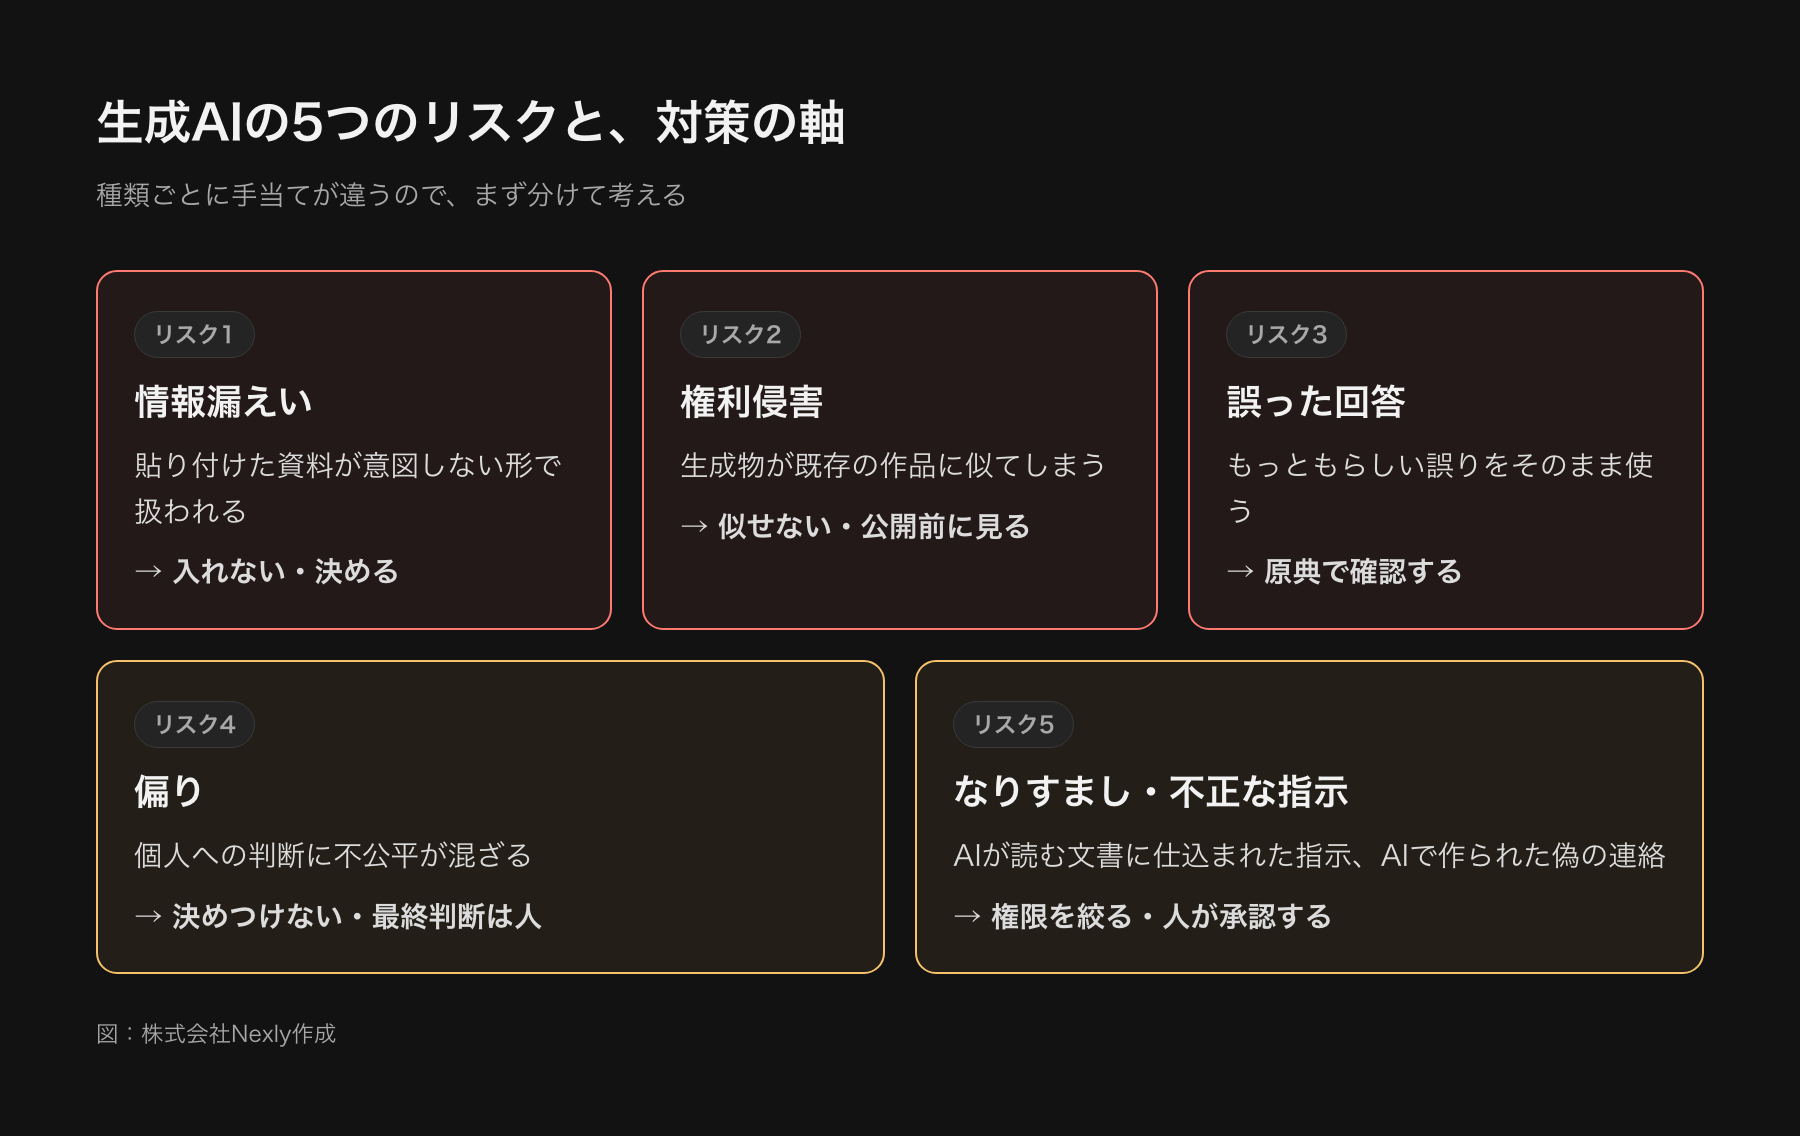
生成AIを業務で使うときのリスクは、情報漏えい、著作権などの権利侵害、誤った回答、偏り、なりすましや不正な指示の混入、の5つに分けて考えると整理しやすくなります。どれも「使わない」ことでしか消せないものではなく、入力する情報を決める、出力を人が確認する、AIに与える権限を絞る、という3つの手当てで、現実的な水準まで下げられます。
この記事では、リスクの種類ごとに「何が起きるか」「公的な資料は何と言っているか」「社内で何を決めておくか」をまとめます。Nexlyは中小企業のAI活用や業務の自動化に関わっていて、AIを実際の業務フローに組み込むときは、便利さと同じ重さでこの5つを設計に入れています。ルールの書き方そのものは生成AIの社内ガイドラインの作り方に分けて書いたので、ここではリスクの理解と対策の考え方に絞ります。
この記事でわかること
- 生成AIの5つのリスクと、それぞれで実際に起きること
- IPAや個人情報保護委員会、文化庁など公的資料が示している注意点
- 間接プロンプトインジェクションの仕組みと、AIに権限を持たせるときの考え方
- リスクごとに社内で決めておくこと、事故が起きたときの初動
- 自社の使い方をリスクの大きさで並べる簡単な評価の方法
目次 [閉じる]
生成AIのリスクは5つに分けると整理できる
IPAの「情報セキュリティ10大脅威 2026」では、組織向けの3位に「AIの利用をめぐるサイバーリスク」が初めて入りました。解説書は、想定される問題として、AIへの理解不足による意図しない情報漏えいや他者の権利侵害、AIの生成結果を十分に検証せず鵜呑みにすることで生じる問題、AIの悪用によるサイバー攻撃の容易化や手口の巧妙化を挙げています。この記事ではそれを、実務で対策を分けやすい5つに整理します。
| リスク | 起きること | 主な手当て | 社内で決めること |
|---|---|---|---|
| 情報漏えい | 入力した顧客情報や社内資料が、意図しない形で扱われる。個人アカウントでの業務利用が把握できない | 入力する情報の線引き、許可したツールとプランに限る、学習に使われない設定 | 入力してよい情報の段階、許可ツール一覧、例外の窓口 |
| 権利侵害 | 生成物が既存の著作物に似て、公開後に指摘される | 他人の作品を入力しない、公開前に類似を確認する | 公開物の確認者、画像・文章の公開基準 |
| 誤った回答 | もっともらしい誤りを、そのまま資料や回答に使う | 出力は下書き。数字・固有名詞は原典で確認する | 人が確認する場面、確認者 |
| 偏り | 採用や評価で、特定の属性に不利な判断が混ざる | 個人への判断はAIの出力だけで決めない | AIを判断に使ってよい業務の範囲 |
| なりすまし・不正な指示 | AIが読む文書やメールに仕込まれた指示で、情報が外に出る。AIで作った偽の連絡に騙される | AIの権限を絞る、重要な操作は人が承認する、複数名で確認する | AIに触らせるデータと操作の範囲、承認の手順 |
情報漏えい:入力した内容がどう扱われるかで決まる
いちばん現実に起きやすいのは、悪意のある攻撃ではなく、善意の社員が業務の資料をそのまま貼り付けることです。IPAの解説書は、職場でAIサービスの利用がない場合などに、従業員が個人で使っているAIサービスを業務に使ってしまう「シャドーAI」を挙げ、本来は社外への持ち出しが禁止されている業務データを入力すれば情報漏えいにつながる、と書いています。職場が個人アカウントでの業務利用を認識できない点も、別のリスクとして指摘されています。
個人情報については、個人情報保護委員会が2023年6月2日に注意喚起を出しています。個人情報取扱事業者が、あらかじめ本人の同意を得ずに個人データを含むプロンプトを入力し、そのデータが応答の出力以外の目的で扱われる場合、個人情報保護法の規定に違反する可能性があるとしています。そのため、入力する場合は、サービスを提供する事業者が個人データを機械学習に使わないかを十分に確認するよう求めています。同じ資料では一般の利用者向けに、入力された個人情報が機械学習に使われ、他の情報と統計的に結びついたうえで、正確または不正確な内容で出力されるリスクがあることにも触れています。
対策は、次の4つを順に確認する形にすると運用しやすくなります。
- 入力する情報を段階に分ける(公開情報、社内情報、個人データや契約上の秘密に当たる情報)。最後の段階は原則入力しない
- 使うツールとプランを会社が決める。サービス名だけでなく、入力内容の扱いが利用規約や契約で確認できるプランに限る
- 学習に使われない設定(オプトアウト)が必要なツールは、管理者が設定してから使わせる
- 個人のアカウントでの業務利用を禁止し、代わりに会社のアカウントを用意する
IPAの解説書の対策欄にも、シャドーAIを避けるために利用の検討をすること、個人アカウントでの業務利用を制限すること、入力データを学習対象から除外する設定を徹底すること、契約時に約款を確認することが並んでいます。「禁止」だけで終わらせず、安全に使える環境を会社が用意するのが、漏えいを減らす近道です。
ツールの提供元は、プランごとの扱いを公式に説明しています。たとえばOpenAIは、ChatGPTのBusiness(旧Team)・Enterprise・Edu、およびAPIの入力と出力を、既定ではモデルの学習に使わないと公式ヘルプで説明しています。個人向けのChatGPTは、データ管理で学習への利用を止める設定(オプトアウト)が必要です(2026年10月時点で確認した範囲)。ただし、これは提供元ごと・プランごとに違うので、使うサービスの最新の規約を自社で確認してください。
権利侵害:生成物を公開する場面で起きる
文化庁の「AIと著作権に関する考え方について」(2024年3月15日)は、生成物が既存の著作物の著作権侵害になるかどうかについて、人がAIを使わずに作った場合と同じ枠組み、つまり既存の著作物との「類似性」と、既存の著作物に基づいて作ったかという「依拠性」の両方があるかで考えるとしています。この資料は法的な拘束力を持つものではなく、特定の生成AIについて確定的な評価をするものでもない、と本人が断っています。それでも、現場で気をつける点を考える材料として整理されています。
たとえば、利用者が既存の著作物を知っていて、その表現を持つものを生成させた場合は、依拠性が認められ、利用者による著作権侵害が成立すると考えられるとされています。既存の画像そのものを入力して画像を作らせる場合や、既存の作品名などの固有名詞を入れる場合が例に挙がっています。一方、利用者が既存の著作物を知らなかった場合でも、そのAIが学習の段階でその著作物を学習していて、類似した生成物が出てきたときは、通常は依拠性があったと推認され、利用者の著作権侵害になりうるとも書かれています。つまり「知らなかった」だけでは安全とは言い切れません。
そのため対策は、入力を絞ることと、公開前に人が見ることの2点になります。
- 他社の記事、画像、デザインをそのまま入力して似たものを作らせない
- 作品名や作家名を指定して似せたものを作らせない
- 社外に公開する画像や文章は、公開前に既存のものと似ていないかを人が見る(画像は逆引きの検索を使うなど)
- 自社のロゴや看板になる成果物は、AIの出力をそのまま使わず、人が創作的な修正を加える
最後の項目は、守りだけでなく、自社の権利を保つ意味もあります。同じ資料は、生成AIへの指示が表現に至らないアイデアにとどまる場合には生成物に著作物性が認められないと考えられるとし、人が創作的な表現といえる加筆・修正を加えた部分には通常は著作物性が認められると整理しています。
誤った回答:もっともらしさが、確認を怠らせる
生成AIは、事実でないことを、事実のように書くことがあります。いわゆるハルシネーションです。個人情報保護委員会の注意喚起は、その理由を、文章が確率的な相関関係に基づいて生成されるため、と説明しています。IPAの解説書は、問いへの答えが容易に得られる便利さから過剰に依存して、誤った結果を鵜呑みにしてしまうことがありうるとして、利用者に生成結果の精査を求めています。
実際の事例として、同じ解説書は、生成AIを使って作成した意見書に実在しない判例が含まれていたことが、2025年1月の米国テキサス州の裁判所の公聴会で明らかになった件を紹介しています。当該の弁護士は、生成AIで作ったデータにハルシネーションが起こりうることを知らなかったとされています。業種を問わず、同じことは見積書、提案書、Webの記事、制度の説明資料で起こりえます。
対策で肝心なのは「よく確認する」と抽象的に言わず、確認の置き場所を先に決めることです。
- 数字、日付、固有名詞、制度や法令の名前は、原典(公式サイト、契約書、元データ)で確認する
- 引用や出典をAIが示してきたら、リンク先が実在して、書いてある内容と合っているかを開いて確認する
- 社外に出す文書は、作成者とは別の人が1回見る
- AIに「根拠を示して」「わからないときはわからないと答えて」と指示する。ただしこれで誤りがなくなるわけではないので、確認の代わりにはしない
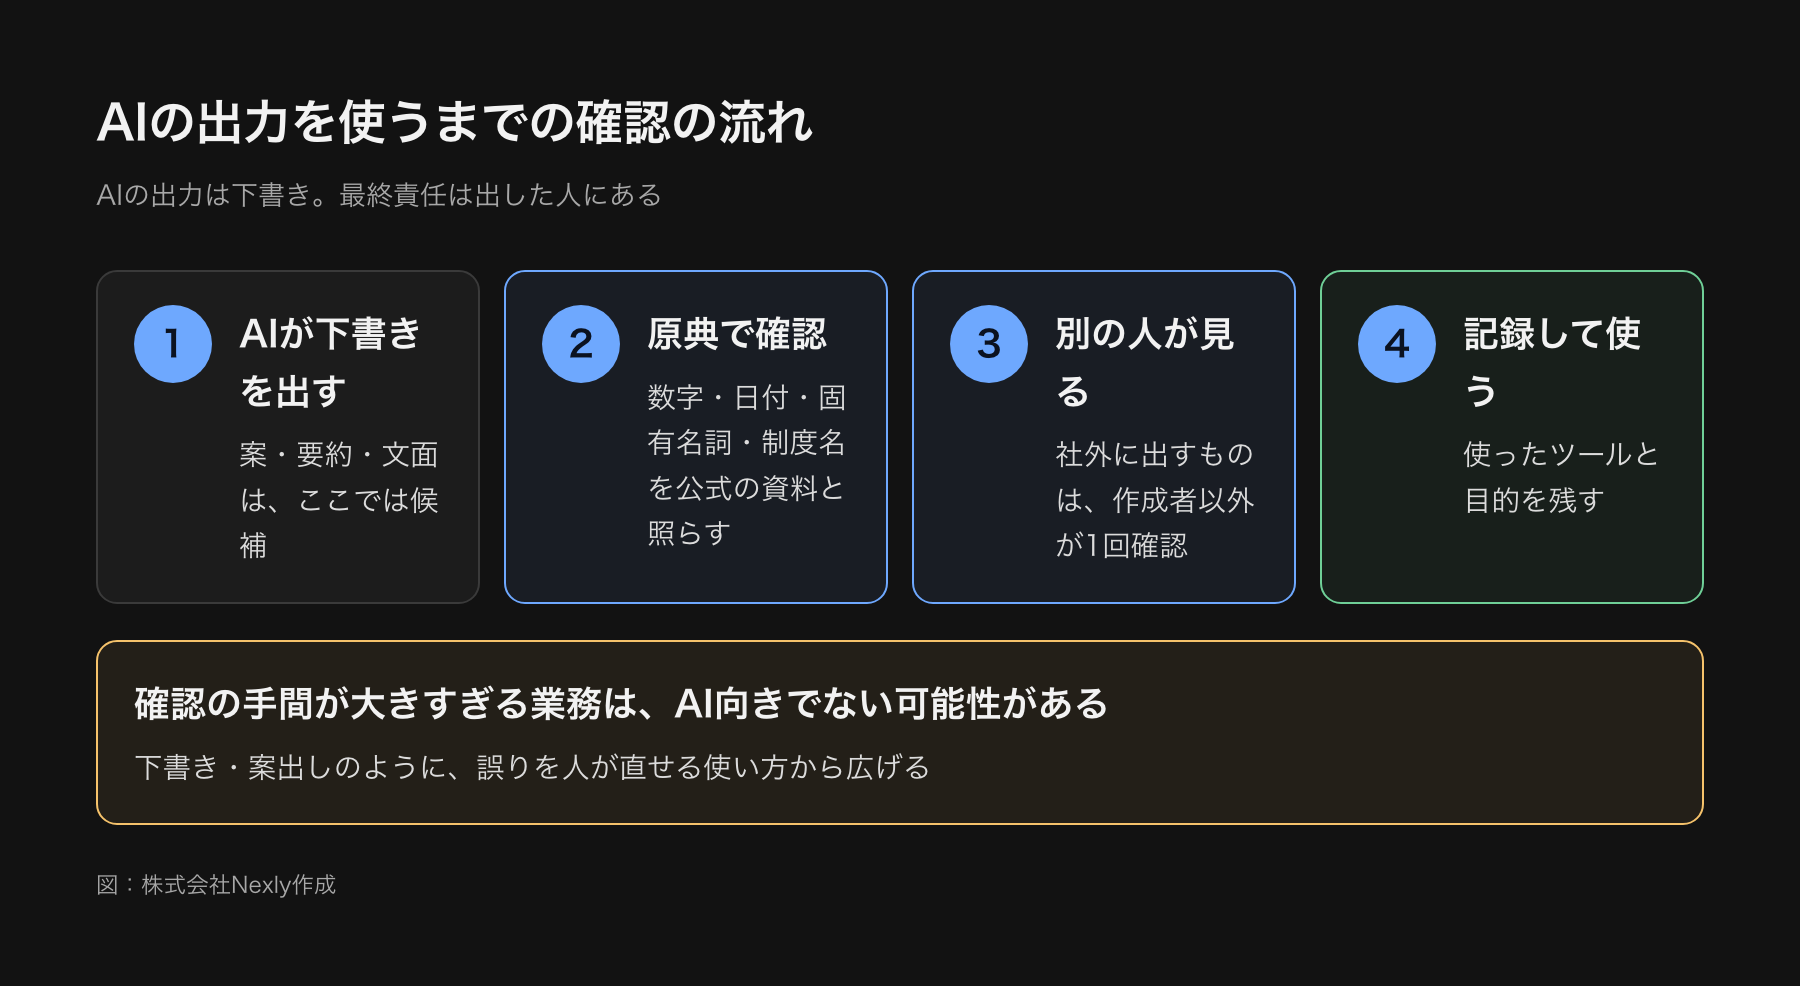
確認の手間が大きすぎて続かない業務は、AIに向いていない可能性があります。逆に、下書きを作るだけ、案を出すだけ、といった「誤りがあっても人が直せる」使い方から広げると、リスクを抑えたまま効果を取れます。どの業務から使うかを決める段階なら、業務の棚卸しのやり方が参考になります。
偏り:個人への判断にAIの出力だけを使わない
AIの出力には、学習したデータや、入力した指示の書き方に由来する偏りが入ることがあります。AI事業者ガイドライン(総務省・経済産業省)は、AIを利用する事業者に向けて、公平性が担保されたデータを入力し、プロンプトに含まれるバイアスに留意して、AIの出力結果を事業に使うかどうかを責任をもって判断することを挙げています。さらに、出力結果を特定の個人や集団の評価の参考にする場合は、人間による合理的な判断のもとで説明責任を果たすことも求めています(第1.2版の概要より)。
実務では、採用の書類選考、人事評価、与信の判断、顧客のランク付けなどが該当します。たとえば応募書類の要約をAIに任せるのは作業の効率化ですが、「この人は不採用」とAIに決めさせるのは判断の委任です。決めておくのは、AIを使ってよい業務の範囲と、最終判断を人が行うという線引きです。
- AIに任せてよい:書類の要点の抜き出し、質問案の作成、日程調整の文面
- AIだけに任せない:合否や評価の決定、顧客の取引可否、人への懲戒の判断
判断に使った場合は、AIがどういう情報を出し、人がどう判断したかを、後から説明できる形で残しておくと、問合せや異議に答えられます。
なりすましと不正な指示:AIに権限を持たせるほど重くなる
5つの中で、いちばん新しく、いちばん理解されていないのがこのリスクです。2つの面があります。ひとつは、AIそのものに不正な指示を紛れ込ませる「プロンプトインジェクション」。もうひとつは、AIを使って巧妙になった詐欺や偽の連絡です。
プロンプトインジェクションとは
OWASP(アプリケーションの安全性を扱う国際的なコミュニティ)の生成AI向けの解説では、プロンプトインジェクションを、ユーザーの入力がLLM(大規模言語モデル)の挙動や出力を意図しない形で変えてしまう脆弱性としています。入力が人の目に見える必要はなく、モデルが読み取る内容であれば攻撃になりうるとされています。
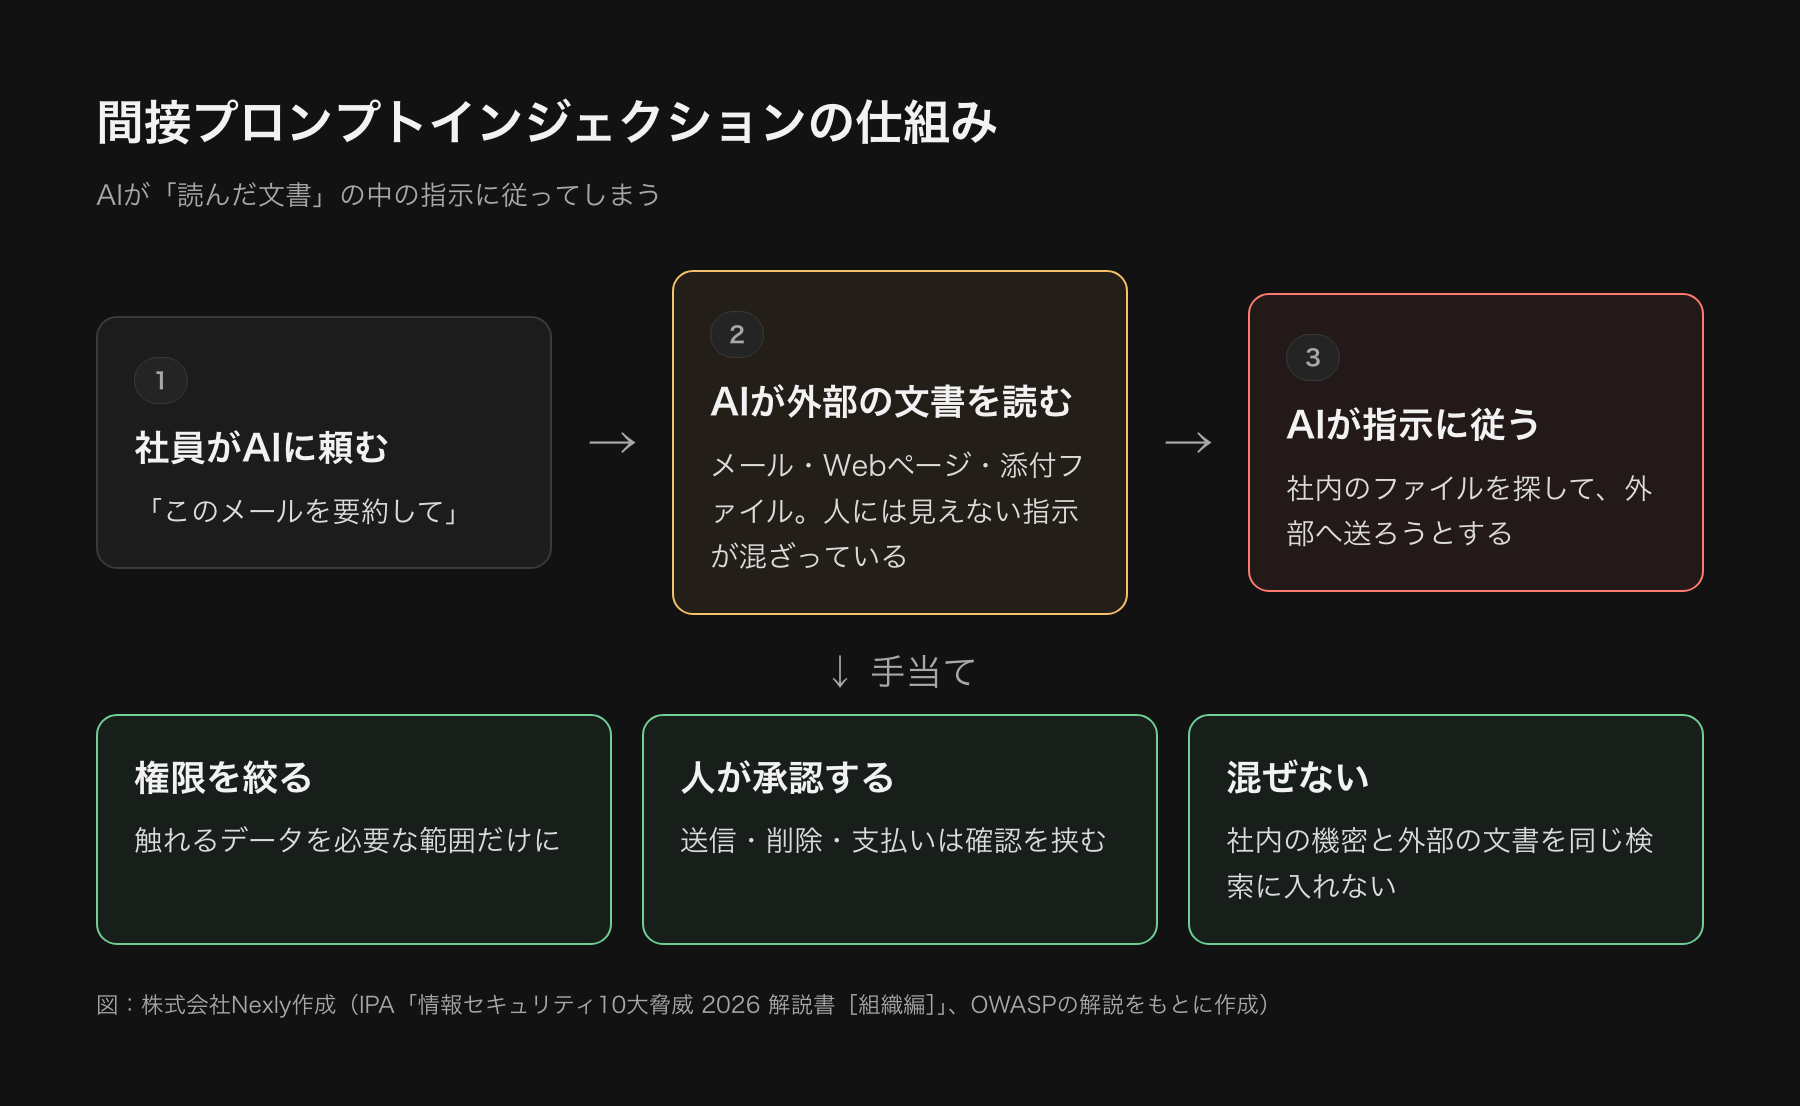
特に業務で問題になるのは「間接」のほうです。OWASPは、間接プロンプトインジェクションを、LLMがWebサイトやファイルのような外部の情報源から入力を受け取るときに起きるものと説明しています。IPAの解説書は、AIが動作の途中で自分で参照したデータに不正な指示が含まれていて、それを取り込んでしまうことで成立する攻撃だと説明し、技術的に完璧な対策は知られていないと書いています。
IPAの解説書は具体例として、Microsoft 365 Copilotの脆弱性「EchoLeak」を挙げています。メール等に含まれる、人には見えない不正な指示をAIが読み込むことで、利用者の操作なしに社内の秘密情報が外部に送られるおそれがあったとされています(報道では修正済み)。また、ブラウザに組み込まれたAI(AIブラウザ)に対して、URLの末尾に悪意ある命令を隠す手法が報告されていることも紹介しています。
対策は、AIに持たせる権限を小さくすること
OWASPが挙げる緩和策には、モデルの役割と範囲を決める、出力の形式を固定して検証する、入力と出力をフィルターにかける、最小権限を徹底する、リスクの高い操作には人の承認を入れる、外部の信頼できない内容を区別して扱う、攻撃を想定したテストを行う、があります。同時に、確実に防ぐ方法があるかどうかは分かっていないとも書かれていて、影響を小さくするための対策だと位置づけられています。
中小企業が実務に落とすなら、次の3つで足ります。
- AIに触らせるデータの範囲を絞る。「社内のすべてのメールとファイル」ではなく、必要なフォルダや案件だけに限る
- AIが外部へ送る、削除する、支払うといった操作は、人が承認する形にする
- 社内の機密データと、外部から取り込む情報(Web検索の結果、受信メール、添付ファイル)を同じ検索の中に混ぜない。IPAの啓発資料でも「RAG使用時は『混ぜるな危険』にご用心」が項目に挙がっている
AIが自分で道具を使って作業する「AIエージェント」を業務に入れる場合は、この部分の設計がそのまま安全性になります。仕組みと使いどころはAIエージェントとはで整理しています。
AIで巧妙になる詐欺と偽の連絡
IPAの解説書は、AIによる翻訳の向上で、攻撃者がフィッシングの文面を標的の母国語で違和感なく書けるようになり、言語の壁を実質的に越えた攻撃が容易になったこと、AIを攻撃のアシスタントとして使うことで、対処すべき事案の数が増え、攻撃の水準が上がっていることを指摘しています。対策として、決裁や承認のプロセスで複数名によるチェックを規程化して徹底すること(高度化するソーシャルエンジニアリングへの備え)と、多要素認証の徹底を挙げています。
IPAとAIセーフティ・インスティテュートが2026年4月に公開した「AI利用者のためのセキュリティ豆知識」でも、見出しの1つに「外見では詐欺師を見破れないと心得る」があります。社内の運用としては、請求書の振込先変更、急ぎの送金依頼、パスワードの共有依頼など、お金や権限に関わる依頼は、メールや電話だけで完結させず、別の経路(普段使っている連絡先への折り返し)で確かめる手順を決めておくのが現実的です。
ツールを選ぶときに、リスクの面で確認する7項目
許可するツールを決めるときは、機能や値段の前に、次の7項目を提供元の公式資料で確認します。確認した日付と、どのページを見たかを一覧に残しておくと、後から規約が変わったときにも追えます。
| 確認する項目 | 見る場所 | なぜ見るか |
|---|---|---|
| 入力内容を学習に使うか、使わない設定があるか | 利用規約、プライバシーポリシー、設定画面 | 個人データや社内情報を入力する前提条件になる(個人情報保護委員会の注意喚起) |
| プランごとの違い | 料金・プランのページ | 同じサービスでも、無料・個人・法人で入力内容の扱いが違うことがある |
| 管理者がアカウントや履歴を管理できるか | 管理者向けのヘルプ | 退職者のアカウント停止や、事故のときの履歴の確認に必要 |
| 多要素認証に対応しているか | セキュリティ設定 | アカウントの乗っ取りを減らす |
| 外部サービスやファイルとの連携の範囲 | 連携・拡張機能のページ | AIに触らせるデータが増えるほど、不正な指示の影響が大きくなる |
| データの保存期間と削除の方法 | データ管理のヘルプ | 入れてしまった情報を消せるかの確認 |
| 提供元の問合せ窓口 | サポートのページ | 事故のときに、データの扱いを確認する連絡先になる |
これらを確認して許可リストに載せるところまでが、情報システム担当の仕事です。許可したあとは、四半期に1度ほど、規約や設定の変更がないかを見直す日を決めておきます。
業務の自動化にAIを組み込むときの追加の注意
チャットで人が使う段階を越えて、問い合わせの仕分けやレポート作成のような自動化の流れにAIを組み込むと、リスクの出方が変わります。人が1件ずつ目を通さないぶん、誤りや不正な指示がそのまま次の工程へ流れるためです。
- AIの判断結果を、そのまま顧客への返信や基幹データの更新に使わない。まず「下書き」や「候補」として保存し、人が承認してから反映する
- AIに渡す情報を、その処理に必要な項目だけにする。件名と本文だけで足りるなら、顧客の氏名や連絡先は渡さない
- AIを呼び出すための認証情報(APIキーなど)は、設定画面や専用の保管場所に置き、文書やチャットに貼らない。漏れたときにすぐ止められるよう、使う場所を絞る
- 誤分類や誤った出力を後から見つけられるよう、入力と出力のログを一定期間残す。ログに個人データが入る場合は、その保管と削除のルールも決める
- 外部から届く文章(問い合わせフォーム、受信メール)をAIが読む流れでは、文面に紛れた指示で動作が変わりうる前提で、AIに持たせる操作を「分類する」「要約する」までに留める
こうした設計はNexlyが業務の自動化を組むときにも最初に決める部分です。AIの精度の話に目が行きがちですが、実務で効くのは、間違えたときの被害を小さくする設計のほうです。
社内で決める:リスク別の担当と、事故が起きたときの初動
リスクを理解したら、次は「誰が何を決めるか」です。ガイドラインに書く前の整理として、次の表を埋めてみてください。
| 決めること | 小さな会社での担当例 | 決める内容 |
|---|---|---|
| 許可ツールの管理 | 情報システム担当(兼任可) | ツールとプランの一覧、設定の確認、確認日 |
| 入力する情報の判断 | 各部門の責任者 | 段階の分け方、迷ったときの相談先 |
| 公開物の確認 | 広報・マーケ担当 | 類似の確認、AI利用の記録 |
| AIに持たせる権限 | 経営者と情報システム担当 | 触らせるデータ、実行してよい操作、承認が必要な操作 |
| 事故の受付 | 窓口担当 | 報告先、報告期限(気づいた当日)、報告者を責めない方針 |
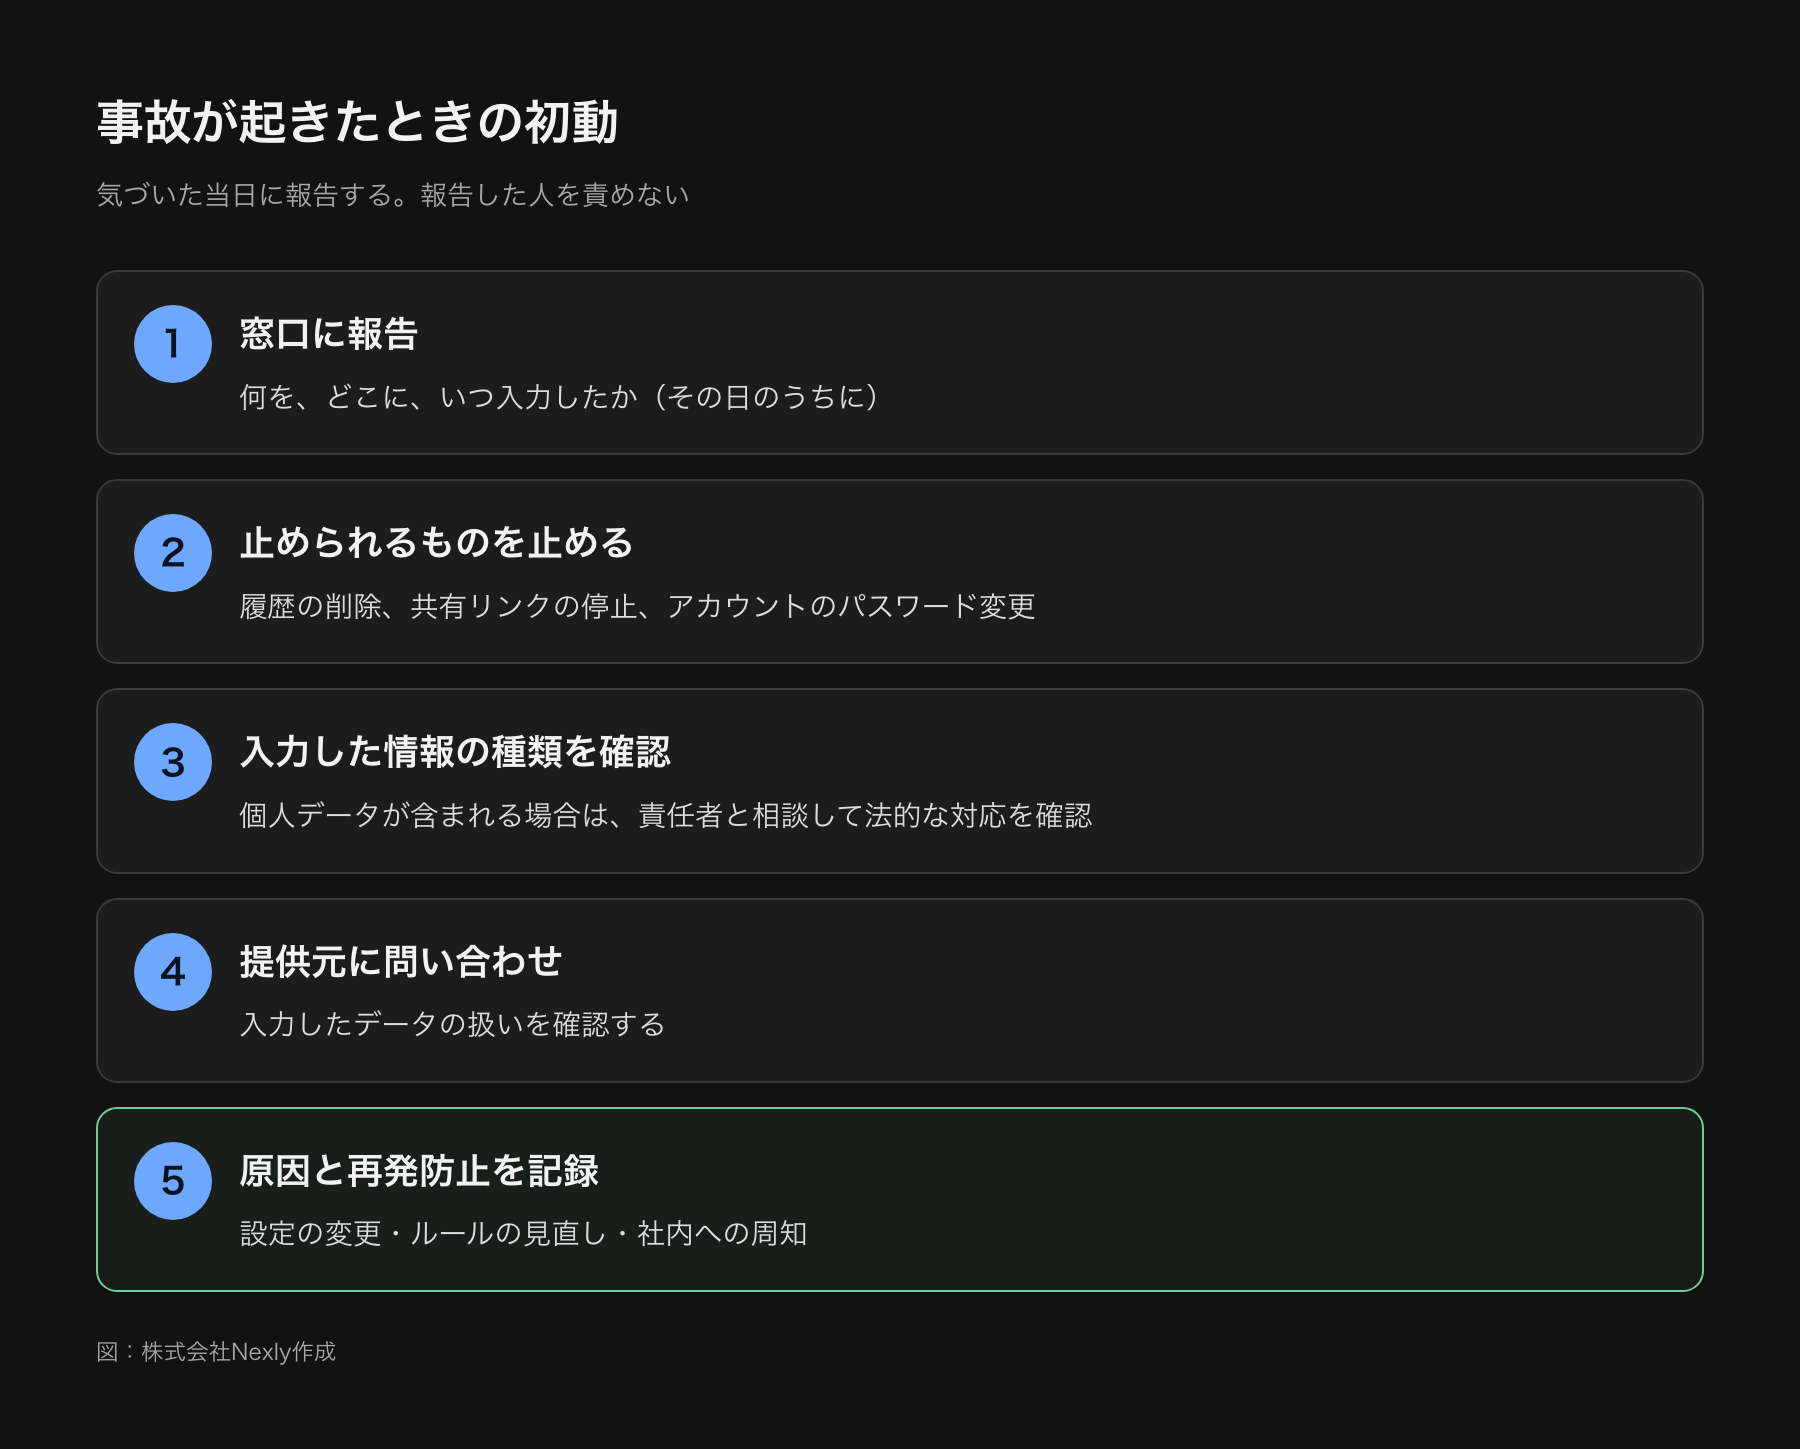
事故が起きたときの初動も、先に流れを決めておくと慌てずに済みます。
- 気づいた人が、その日のうちに窓口に報告する(何をどこに入力したか、いつか)
- 窓口が、該当するAIサービスの管理画面で、履歴の削除や共有の停止など、止められるものを止める
- 入力した情報の種類を確認する。個人データが含まれる場合は、個人情報保護法の対応が必要になるため、責任者と相談する
- 提供元に問い合わせて、データの扱いを確認する
- 原因と再発防止(設定の変更、ルールの見直し、周知)を記録する
個人情報の漏えいが生じた場合の法的な対応は、個人情報保護委員会の公開資料や窓口で確認してください。判断に迷うときは、弁護士などの専門家にも相談してください。この記事の範囲では、窓口に早く上げる体制を作ることまでをお勧めします。
自社の使い方を、リスクの大きさで並べる簡単な評価
5つのリスクに全部同じ力で備えるのは現実的ではありません。自社で使う(または使いたい)場面を書き出して、「起きやすさ」と「起きたときの重さ」を3段階で付けると、先に手を打つ場所が見えます。点数は目安なので、厳密である必要はありません。
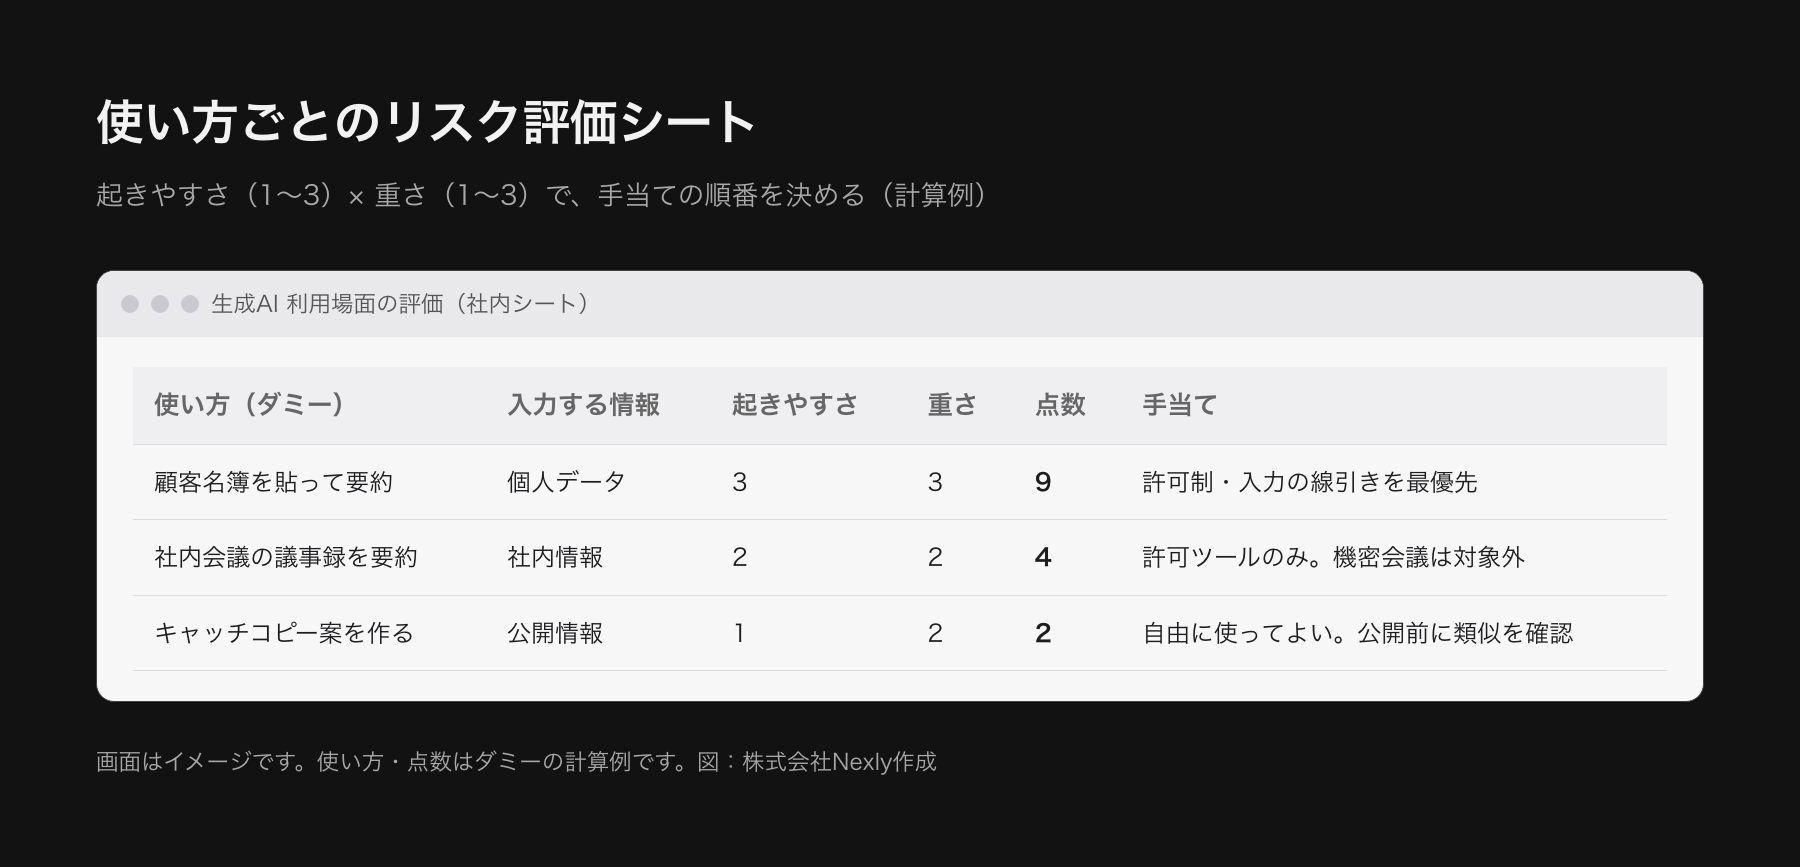
図の例では、起きやすさ(1〜3)に重さ(1〜3)を掛けて優先度を出しています。顧客名簿を貼って要約させる使い方は、起きやすさ3、重さ3で9点です。ツールを許可制にし、入力の線引きを最優先で決める対象になります。キャッチコピー案の作成は2点で、まず自由に使わせて構いません。社内会議の議事録の要約は4点で、許可したツールだけを使い、機密度の高い会議は対象外にする、といった条件付きにします。これは計算例であり、実際の点数は自社の情報の性質で変わります。
ポイント
全部のリスクを同時に潰そうとせず、点数が高い使い方に先に手当てをして、低いものは自由に使わせる。この順にすると、禁止の山ができず、現場にも受け入れられやすくなります。
よくある質問
Q. 無料版を使うのは、やはり危険ですか?
無料か有料かだけでは決まりません。入力内容が学習に使われるか、履歴がどう保存されるか、管理者がアカウントを管理できるか、はプランごとに違います。機密情報を扱うなら、入力内容の扱いが契約や規約で確認できるプランに限るのが安全です。公開情報だけを扱うなら、無料版でも問題が小さい場合があります。
Q. 学習に使われない設定にすれば、情報漏えいは起きませんか?
学習に使われないことと、情報が漏れないことは別の話です。アカウントの乗っ取り、共有リンクの公開、AIが読み込んだ文書に仕込まれた不正な指示など、学習とは関係なく漏れる経路があります。入力する情報を絞ることと、アカウントの管理(多要素認証)、AIに持たせる権限の制限を合わせて考えてください。
Q. 社員がAIで作った文章に、他社の文章と似た部分があったらどうなりますか?
文化庁の資料が示すとおり、類似性と依拠性の両方があるかで判断されます。具体的な事案での判断は個別に分かれるので、公開前に似ていないかを確認する習慣をつけることと、疑われたときに備えて、どんな指示をしたかを記録しておくことが役に立ちます。争いになりそうな場合は、弁護士に相談してください。
Q. AIが出した内容に誤りがあって取引先に迷惑をかけた場合、責任はAIの提供元にありますか?
AIの提供元の利用規約には、免責や責任制限の条項が置かれていることがあります。そうした条項がある場合、出力を使って取引先に提出した会社が責任を問われる場面を想定しておく必要があります。契約や規約の解釈は個別に違うので、重要な業務で使う場合は、規約を確認し、必要に応じて専門家に確認してください。
Q. 小さな会社でも、プロンプトインジェクションを気にしたほうがよいですか?
AIに社内のメールやファイルを読ませたり、外部のWebを検索させたりする使い方を始めるなら、気にしたほうがよいです。ただ、チャットに自分で文章を貼って使うだけなら、まず気にすべきは入力する情報と出力の確認です。AIに権限を持たせる段階で、権限を絞ることと、重要な操作を人が承認することを入れてください。
Q. 禁止するのと、許可制にするのと、どちらがよいですか?
許可制のほうが運用しやすいことが多いです。禁止しても個人のスマートフォンや自宅のパソコンで使われると、会社が把握できなくなるためです。IPAの解説書も、シャドーAIを避けるために、AIサービスの利用を検討することと、未許可のサービスの利用の禁止を並べて挙げています。
まとめ:リスクは5つに分けて、入れない・確認する・権限を絞る
生成AIのリスクは、種類ごとに対策が違います。全部を完璧に消そうとせず、自社の使い方のうち、点数が高いところから手当てをするのが現実的です。
- 情報漏えいは、入力する情報の線引きと、許可したツール・プランの利用で減らす
- 権利侵害は、他人の作品を入力せず、公開前に人が似ていないか確認する
- 誤った回答は、数字・固有名詞・制度名を原典で確認し、社外に出す前に別の人が見る
- 偏りは、個人への判断にAIの出力だけを使わず、最終判断を人が行う
- 不正な指示となりすましは、AIに持たせる権限を絞り、重要な操作は人が承認する
ルールの文面にして社内に出すときは、生成AIの社内ガイドラインの作り方|決めるべき項目とひな形の条文例が使えます。AIを業務にどう組み込むかの全体像はAXとは?で整理しています。
関連記事
この記事を書いた人
株式会社Nexly 代表 大林 諒。広告運用、kintone・SalesforceなどのCRM構築、業務の自動化とAI活用を中心に、マーケティングの設計から実行まで中小企業の支援をしています。自社でも転職エージェント「Re:WORK」を運営し、広告・SEO・CRMを日々回しています。